マルチエージェントシステムとは?【やり方やAIの仕組み】実用例まで紹介
AIエージェントマルチエージェントとは、役割の異なる複数のAIエージェントが作業を分担し、途中の結果を受け渡しながら1つの目的を達成する仕組みです。
人間のプロジェクトチームのように、統括役が仕事を割り振り、調査役や作成役が手を動かし、確認役が仕上がりを検証します。
もともとは知的エージェントを複数動かす研究分野の言葉で、交通や市場を再現するマルチエージェントシミュレーションや、マルチエージェント強化学習もこの流れにあります。
生成AIの普及後は、ChatGPTやClaudeのようなLLMを使ったAIエージェントを組み合わせる設計を指す場面が増えました。
ただし、エージェントを増やせば必ず成果が上がるわけではありません。
Anthropicの公開データでは、マルチエージェント構成はチャットの約15倍のトークンを消費します。
独立して並列に進められる作業が多く、成果物の価値がコストに見合う業務で使い、それ以外はシングルエージェントで十分です。
成果を決めるのはエージェントの数ではなく、役割の分け方と受け渡しの設計です。
この記事では、マルチエージェントの意味と仕組み、実用例、メリット・デメリット、使うべきかの判断基準、主要ツール7選、始め方までを順に整理します。
マルチエージェントの意味|研究分野と生成AIで指すものが異なる
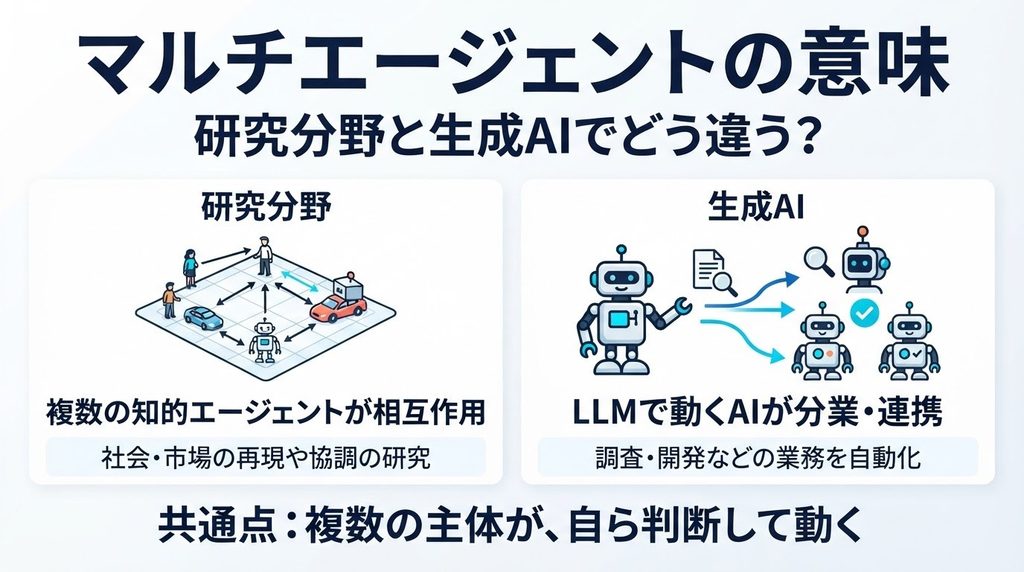
マルチエージェントの意味は、研究分野では「複数の知的エージェントが互いに影響し合う系」、生成AIの文脈では「LLMで動くAIエージェント同士の分業」を指します。
どちらも、自分で判断して動く主体が複数いて、協力や競争を通じて全体の結果が決まる点は共通です。
違うのは、エージェントの中身と目的です。
| 観点 | 研究分野のマルチエージェント | 生成AIのマルチエージェント |
| エージェントの中身 | ルールや学習モデルで動くプログラム、ロボット、シミュレーション上の人や車 | 大規模言語モデル(LLM)とツールを組み合わせたAIエージェント |
| 主な目的 | 社会や市場の振る舞いの再現、分散制御、協調の研究 | 調査・開発・問い合わせ対応などの業務を分担して自動化 |
| 代表的な用語 | 知的エージェント、マルチエージェントシミュレーション、マルチエージェント強化学習 | AIエージェント、サブエージェント、オーケストレーター |
検索で「マルチエージェント」を調べると両方の意味の記事が混ざるため、読んでいる記事がどちらの意味で使っているかを最初に確かめると混乱しません。
ビジネスで導入を検討しているなら、知りたのはほぼ生成AI側の意味です。
研究分野で使われてきたマルチエージェント(知的エージェント・シミュレーション・強化学習)
研究分野で使われてきたマルチエージェントは、周囲の状況を知覚して自ら行動を選ぶ「知的エージェント」を複数置き、その相互作用を調べるための考え方です。
主な研究テーマは、エージェント同士の協調・交渉、マルチエージェントシミュレーション、マルチエージェント強化学習の3つです。
知的エージェントは、AIの代表的な教科書であるRussellとNorvigの『Artificial Intelligence: A Modern Approach』で、センサーで環境を知覚し、アクチュエーターで環境に働きかけるものとして定義されています。
この定義に当てはまれば、ロボットでもソフトウェアでも、シミュレーション上の歩行者でもエージェントです。
マルチエージェントシミュレーションは、人や車、企業をエージェントとしてモデル化し、個々のルールから全体の動き(渋滞、避難の流れ、価格変動)を再現する手法です。
マルチエージェント強化学習は、複数のエージェントが報酬をもとに試行錯誤し、協力や競争の戦略を学ぶ手法で、ロボットの群制御や信号制御などで研究されています。
自律エージェントとマルチエージェントシステムを扱う国際会議AAMASが毎年開かれており、生成AIが登場する前から確立した研究領域です。
研究分野のマルチエージェントは「業務の自動化」より「複数の主体の振る舞いを理解・再現すること」が主な目的だと押さえておくと、生成AIの話と混同しません。
生成AI時代のマルチエージェント(AIエージェントによる分業)
生成AI時代のマルチエージェントは、LLMを頭脳にしたAIエージェントを複数用意し、調査・作成・検証などの工程を分業させる設計を指します。
1つのAIにすべてを頼むのではなく、役割ごとに指示・使えるツール・参照する情報を分けるのが特徴です。
ここでいうAIエージェントは、LLMがツール(検索、コード実行、社内データの参照など)を使いながら、目的を達成するまで判断と行動を繰り返すプログラムです。
Anthropicは、マルチエージェントシステムを「ツールをループで自律的に使うLLM(エージェント)が複数で協働するもの」と説明しています。
分業させる理由は、1つのAIに長い指示と大量の情報を詰め込むと、指示の取りこぼしや判断の混乱が起きやすいためです。
役割を分ければ、各エージェントは自分の担当に必要な情報だけを持って作業できます。
例えば、Claudeのリサーチ機能では、統括役のエージェントが調査計画を立て、複数のサブエージェントが並列にWeb検索を行い、結果を統括役がまとめます。
ChatGPTを提供するOpenAIもAgents SDKでエージェント間の引き継ぎ(ハンドオフ)を提供しており、GitHub CopilotやClaude Codeでもサブエージェントに作業を任せられます。
生成AIのマルチエージェントは、AIエージェントによる「分業の設計」のことで、身近なツールでも試せる段階に来ています。
マルチエージェントは研究用語にとどまらず、業務の分業を設計する手法として使える段階にあります。
自社のどの業務で試せるかを整理したい場合は、下記から相談できます。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
マルチエージェントシステムとは?
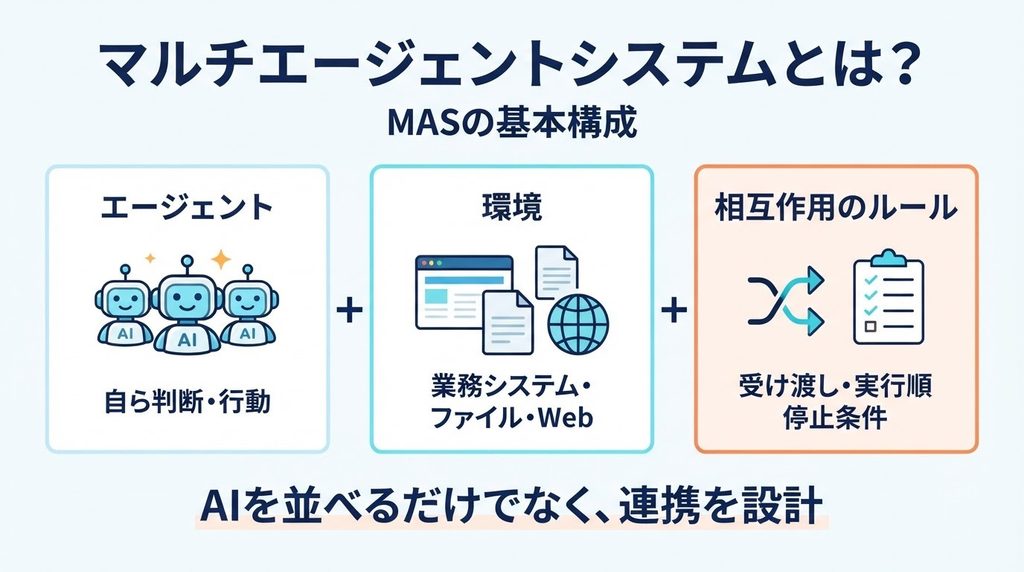
マルチエージェントシステム(MAS:Multi-Agent System)とは、複数のエージェント、エージェントが動く環境、エージェント同士のやり取りのルールの3つで構成される仕組み全体を指します。
「マルチエージェント」が考え方を表す言葉なら、マルチエージェントシステムはそれを実際に動く形にしたものです。
- エージェント:自分で判断して行動する主体。生成AIではLLMとツールを組み合わせたAIエージェント
- 環境:エージェントが観察し、働きかける対象。業務システム、ファイル、Webなど
- 相互作用のルール:誰が誰に何を渡すか、どの順で動くか、いつ止めるか
3つのうち、成果を左右するのは相互作用のルールです。
同じモデルを使っても、受け渡す情報の形式や停止条件が曖昧だと、作業の重複や終わらないやり取りが起きます。
Anthropicの公開記事では、初期のエージェントが単純な質問に50体のサブエージェントを起動するといった失敗をしていたと報告されています。
マルチエージェントシステムは「AIを複数並べたもの」ではなく、「役割とやり取りのルールまで設計した仕組み」だと理解しておくと、この後の仕組みや判断基準の話が読みやすくなります。
マルチエージェントAIと似ている用語の違い
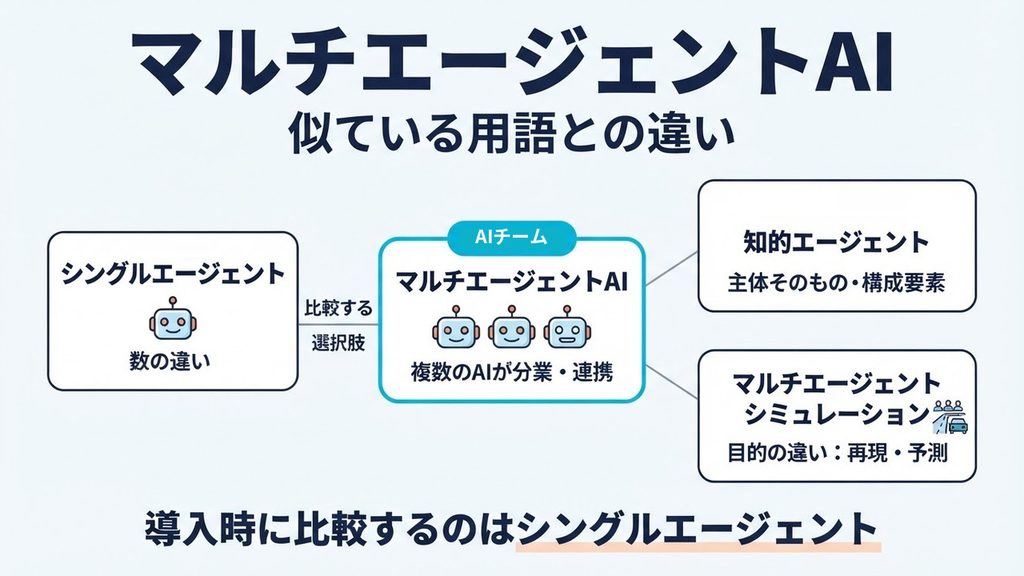
マルチエージェントAIと似ている用語の違いは、「エージェントの数」「エージェントの中身」「目的」の3点で見分けられます。
特に混同されやすいのは、シングルエージェント、知的エージェント、マルチエージェントシミュレーションの3つです。
| 用語 | マルチエージェントAIとの違い | 関係 |
| シングルエージェント | 1つのAIエージェントが全工程を担当する | 数の違い(どちらを選ぶか) |
| 知的エージェント | 自律的に判断する主体そのものを指す概念で、1体でも成り立つ | 部品と全体の違い |
| マルチエージェントシミュレーション | 業務の自動化ではなく、現実の振る舞いの再現・予測が目的 | 目的の違い |
シングルエージェントとは「どちらを選ぶか」の関係、知的エージェントとは「構成要素」の関係、マルチエージェントシミュレーションとは「同じ考え方の別用途」の関係にあります。
導入を検討する場面で比べるべきなのはシングルエージェントで、ほかの2つは用語の整理として押さえておけば十分です。
シングルエージェントとの違い
シングルエージェントとの違いは、1つのAIエージェントが全工程を順番に処理するか、複数のエージェントが役割を分けて分担・並列で処理するかです。
性能はマルチエージェントが上回る場面がある一方、コストと待ち時間はシングルエージェントの方が小さく抑えられます。
| 観点 | シングルエージェント | マルチエージェント |
| 処理の流れ | 1体が調査から回答まで順に進める | 統括役が分解し、専門役が分担・並列で進める |
| 得意な仕事 | 手順が決まった問い合わせ、要約、短いコード修正 | 調べる方向が多い調査、工程の多い開発、複数観点の検証 |
| コスト | 小さい | 大きい(やり取りの分だけ増える) |
| 問題の追跡 | しやすい | 記録の仕組みがないと難しい |
差が数字で示された例が、Anthropicのリサーチ機能です。
同社の社内評価では、Claude Opus 4を統括役、Claude Sonnet 4をサブエージェントにしたマルチエージェント構成が、Claude Opus 4単体の構成を90.2%上回りました。
S&P 500の情報技術セクター企業の取締役を全員挙げる課題では、マルチエージェント構成は課題を分割して正解にたどり着き、単体の構成は逐次的な検索が遅く答えを見つけられませんでした。
一方で同社は、エージェントはチャットの約4倍、マルチエージェント構成は約15倍のトークンを使うとも公表しています。
マルチエージェントは「性能を上げる代わりにコストを払う」選択肢であり、シングルエージェントで足りる仕事にまで使う必要はありません。
知的エージェントとの違い
知的エージェントとの違いは、知的エージェントが「自律的に判断して行動する主体」1つを指す概念であるのに対し、マルチエージェントはその主体が複数集まって相互作用する仕組みを指す点です。
つまり、知的エージェントはマルチエージェントの部品にあたります。
知的エージェントは、環境を知覚し、目的に照らして行動を選ぶものとして定義され、刺激に反応するだけの単純なものから、目標やどれだけ望ましいかを基準に計画を立てるものまで段階があります。
今のAIエージェントは、LLMで状況を判断し、ツールを使って行動するため、知的エージェントの一種と捉えられます。
生成AIの文脈に置き換えると、ChatGPTやClaudeに検索やファイル操作を任せて1体で動かす状態が「知的エージェントを1つ使っている」状態です。
そこに検証役や調査役を加えて連携させると、マルチエージェントになります。
知的エージェントは1体でも成り立つ概念なので、「知的エージェント=マルチエージェント」ではありません。
両者の関係は「部品」と「部品を組み合わせたチーム」と覚えておくと整理しやすくなります。
マルチエージェントシミュレーションとの違い
マルチエージェントシミュレーションとの違いは目的にあります。
マルチエージェントシミュレーションは現実の人や車、組織の振る舞いを仮想空間で再現して比べる手法で、生成AIのマルチエージェントは業務を分担して成果物を作る仕組みです。
シミュレーションでは、エージェント1体ごとに「混んでいたら別の道を選ぶ」「価格が上がったら買い控える」といったルールを持たせ、多数のエージェントを同時に動かして全体の変化を観察します。
避難計画、交通渋滞、感染症の広がり、サプライチェーンの滞留などを、実際には試せない条件で比較するために使われます。
一方、生成AIのマルチエージェントは、調査役や作成役が協力してレポートやコードを仕上げることが目的です。
シミュレーションでは多数のエージェントを同時に動かすことが前提になるのに対し、業務用では数体から十数体の構成が中心です。
最近は、LLMで動くエージェントをシミュレーション上の住民として使う研究も進んでおり、両者の境界は重なりつつあります。
「何かを再現したいのか、何かを作りたいのか」で見分けると迷いません。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
マルチエージェントシステムの仕組みと役割
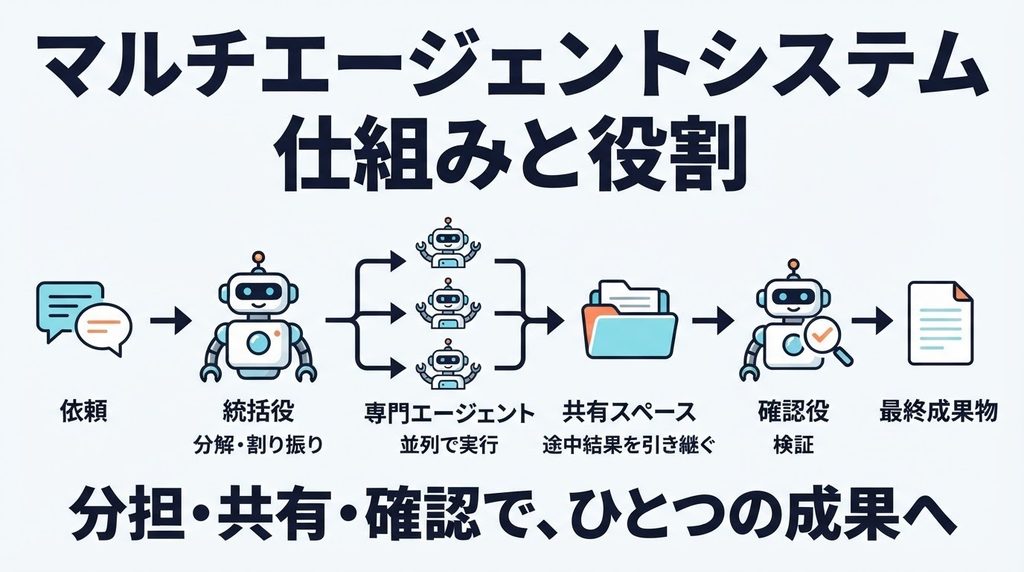
マルチエージェントシステムは、統括役がタスクを分解して割り振り、専門エージェントが実行し、途中結果を共有して引き継ぎ、確認役が検証して仕上げる、という4つの役割で動きます。
人間のチームでいえば、プロジェクトマネージャー、担当者、引き継ぎ資料、品質チェックにあたります。
- 統括役:依頼を受け取り、サブタスクに分けて担当を決める
- 専門エージェント:担当のサブタスクを、専用の指示とツールで実行する
- 共有と引き継ぎ:途中の結果を決まった形式で次の担当や統括役に渡す
- 確認役:結果を検証し、最終成果物にまとめる
4つの役割のどれが欠けても、重複・抜け・誤りのいずれかが起きます。
以下、Claudeのリサーチ機能の公開情報を例に、役割ごとの動きを示します。
統括役が依頼を受け取り、タスクを分解して割り振る
統括役(オーケストレーター)は、ユーザーの依頼を受け取って目的を読み取り、担当ごとのサブタスクに分解して割り振る役です。
マルチエージェントの成否はここで決まり、割り振りの指示が曖昧だと、専門エージェントが同じ作業を重ねたり、抜けが出たりします。
Anthropicのリサーチ機能では、統括役が依頼を分析して調査戦略を立て、計画をメモリに保存したうえでサブエージェントを生成します。
計画を保存するのは、コンテキストウィンドウ(AIが一度に保持できる情報量)が20万トークンを超えると内容が切り捨てられるためです。
同社は、統括役がサブエージェントに渡す指示には「目的」「出力形式」「使うツールと情報源」「担当範囲の境界」が必要だとしています。
初期は「半導体不足を調べて」のような短い指示を出していたため、ある担当が2021年の車載半導体の危機を調べ、別の2体が2025年のサプライチェーンという同じ論点を重複して調べる事態が起きました。
統括役の仕事は「分けること」ではなく「重ならず漏れない指示を書くこと」です。
自社で設計する際も、サブタスクごとに目的・出力形式・ツール・担当範囲の4項目を書き出すところから始めると失敗を減らせます。
専門エージェントが担当のタスクを実行する
専門エージェントは、統括役から受け取ったサブタスクだけに集中し、専用の指示・ツール・参照情報を使って実行する役です。
担当範囲を絞ることで、1体あたりの指示が短くなり、必要な情報だけで判断できます。
Anthropicのリサーチ機能では、各サブエージェントが独立してWeb検索を繰り返し、検索結果の質を評価しながら次の検索語を調整します。
同社はサブエージェントを、膨大な情報から重要な部分だけを抜き出して統括役に返す「フィルター」にたとえています。
専門エージェントを分ける基準は、主に3つあります。
- 扱う情報源が違う(Web、社内文書、データベース)
- 使うツールや権限が違う(読み取りだけ、コード実行、書き込み)
- 求める出力が違う(下書き、データ表、修正案)
権限の分け方は安全面でも効きます。
Claude Codeのサブエージェントは担当ごとに使えるツールを制限でき、レビュー役には読み取りのツールだけを渡すといった設計が可能です。
担当を分けるときは「何を任せ、何を触らせないか」まで決めておくと、事故を防げます。
エージェント同士が途中の結果を共有して引き継ぐ
エージェント同士が途中の結果を共有して引き継ぐ工程では、渡す情報の中身と形式を決めておくことが品質を左右します。
人間の業務で引き継ぎ資料が雑だと手戻りが起きるのと同じで、AI同士でも情報が欠けたり歪んだりすると、後工程の精度が落ちます。
引き継ぎには大きく2つの方法があります。
1つは、結果を統括役に返し、統括役が次の担当に渡す方法です。
もう1つは、共有の保存先(ファイルやデータベース)に成果物を置き、参照先だけを渡す方法です。
Anthropicは後者を勧めています。
サブエージェントが成果物を外部に保存して軽い参照情報だけを統括役に返すことで、伝言ゲームのような情報の欠落を防ぎ、長い出力をやり取りする分のトークンも減らせるとしています。
コードやレポート、データの可視化など、構造のある成果物で特に効果があるといいます。
引き継ぎで渡す項目の例は、目的、結論、根拠とした出典、未解決の点、次の担当への依頼です。
引き継ぎの形式を決めておけば、どのエージェントがどこで情報を落としたかを後から追えるため、デバッグの負担も下がります。
確認役が結果を検証して最終的な成果物にまとめる
確認役は、専門エージェントの結果を検証し、基準を満たしたものだけを最終成果物にまとめる役です。
作った本人とは別のエージェントが確認することで、根拠のない記述や見落としを拾いやすくなります。
Anthropicのリサーチ機能では、調査が終わると「CitationAgent」と呼ばれる専用エージェントが文書とレポートを照らし合わせ、各主張に対応する出典の位置を特定します。
主張と出典の対応を確認してから回答を返す仕組みです。
確認役に持たせる基準は、成果物の種類で変わります。
| 成果物 | 確認役が見る点 |
| 調査レポート | 主張と出典が一致しているか、一次情報を使っているか |
| コード | テストが通るか、既存の機能を壊していないか |
| 問い合わせへの回答 | 社内規程と矛盾しないか、答えてはいけない内容を含まないか |
確認役が基準を満たさないと判断した場合に、どの担当に差し戻すか、何回まで差し戻すかも決めておきます。
差し戻しの上限がないと、作成と確認の往復が終わらなくなります。
ただし、確認役もAIである以上、見落としはゼロになりません。
契約や医療、金額の確定のように影響が大きい判断は、最後に人が承認する設計にしておくことが前提です。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
マルチエージェントの仕組み|エージェントの分業と連携の型
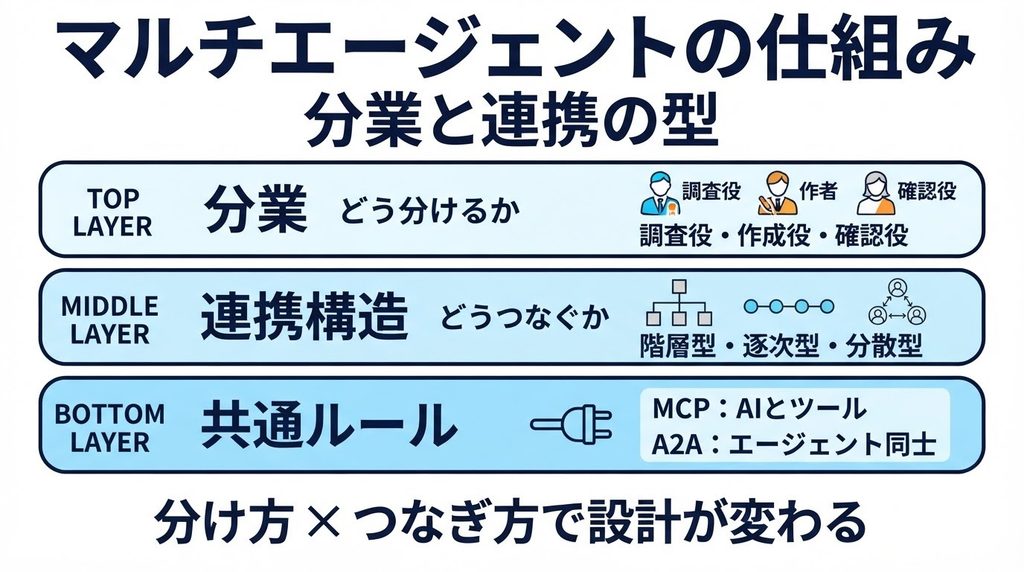
マルチエージェントの仕組みは、「仕事をどう分けるか」と「エージェント同士をどうつなぐか」の2つで決まります。
分け方は工程・情報源・観点のいずれかで専門役を作るのが基本で、つなぎ方は統括役の有無によって階層型・逐次型・分散型の3つに分かれます。
さらに、異なるツールや他社のエージェントをつなぐ場合は、MCPやA2Aといった共通ルールで受け渡しをそろえます。
| 設計の要素 | 決めること | 代表例 |
| 分業 | どの単位で専門役を作るか | 調査役・作成役・確認役 |
| 連携構造 | 誰が指示し、どの順で動くか | 階層型・逐次型・分散型 |
| 共通ルール | ツールや他のエージェントとどうつなぐか | MCP、A2A |
前の見出しで示した4つの役割は、この3要素を組み合わせたときの典型的な流れの1つです。
同じ4役でも、連携構造を変えると速度やコスト、制御のしやすさが大きく変わるため、型を知っておくと設計の選択肢が広がります。
例えばAnthropicのリサーチ機能は階層型、OpenAI Agents SDKを使った受付と担当の振り分けは分散型にあたります。
1つの仕事を専門役のエージェントで分担する
1つの仕事を専門役のエージェントで分担するときは、「工程」「情報源」「観点」のどれで分けるかを先に決めます。
分け方を決めずにエージェントを増やすと、担当範囲が重なり、同じ作業の繰り返しやコスト増につながります。
| 分け方 | 例 | 向く仕事 |
| 工程で分ける | 調査役→執筆役→校正役 | 手順が決まった文書作成、開発 |
| 情報源で分ける | Web担当、社内文書担当、データベース担当 | 複数の情報源をまたぐ調査 |
| 観点で分ける | セキュリティ担当、性能担当、読みやすさ担当 | コードレビュー、提案書の検証 |
工程で分ける方法は人間の業務フローに近く、最初に試しやすい型です。
Siemensの事例も、検索、要件整理、影響分析、タスク分解、実装と、工程で専門役を分けた例です。
情報源で分ける方法は、Anthropicのリサーチ機能のように並列で調べる仕事に向きます。
観点で分ける方法は、1つの成果物を複数の目で検証したいときに使います。
分ける単位の目安は、そのサブタスクだけを渡されても、担当者が迷わず作業できるかです。
前後の工程の文脈がないと進められないなら、分けずに1体で処理した方がよい場合もあります。
専門役は多いほど良いのではなく、「独立して任せられる単位」で切るのが原則です。
統括役の有無で変わる3つの連携構造
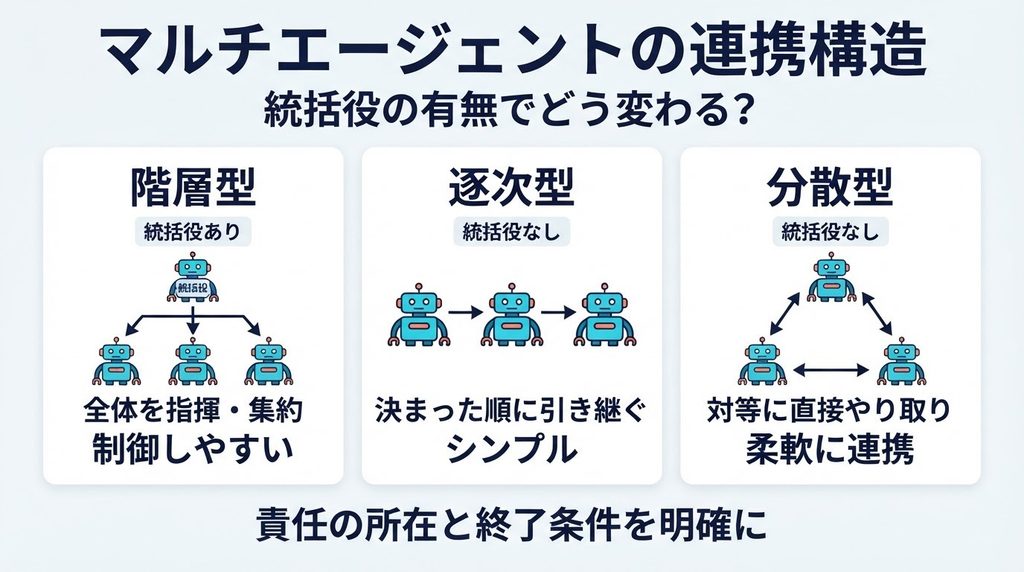
マルチエージェントの連携構造は、統括役が全体を指揮する「階層型」、統括役を置かず決まった順に引き継ぐ「逐次型」、エージェント同士が対等にやり取りする「分散型」の3つに大別できます。
制御のしやすさは階層型、シンプルさは逐次型、柔軟さは分散型が優れています。
| 構造 | 統括役 | 動き方 | 向く仕事 | 注意点 |
| 階層型 | あり | 統括役が分解して割り振り、結果を集約 | 調査、複雑な開発 | 統括役の指示の質に全体が左右される |
| 逐次型 | なし(順番で代替) | 担当が終わると次の担当へ渡す | 手順が固定された業務 | 1か所の遅れや誤りが後ろに響く |
| 分散型 | なし | 状況に応じてエージェント同士が直接やり取り | 問い合わせの振り分け、柔軟な協業 | ループや責任範囲の曖昧さが起きやすい |
階層型は「オーケストレーター・ワーカー型」「スーパーバイザー型」とも呼ばれ、生成AIのマルチエージェントで最もよく使われる構造です。
Anthropicのリサーチ機能もこの型で、統括役が3〜5体のサブエージェントを並列に起動します。
統括役が全体を把握するため、どこで何が起きているかを追いやすく、途中で方針を変える判断も統括役が担えます。
一方で、統括役が全員の結果を待つ間は全体が止まりやすく、Anthropicも、統括役がサブエージェントの完了を同期的に待つ方式が情報の流れのボトルネックになると認めています。
逐次型は「パイプライン型」とも呼ばれ、調査役が終わったら執筆役、次に校正役と、決まった順に作業を渡します。
CrewAIのように、タスクを順番に実行する進め方を設定で選べるフレームワークもあります。
流れが単純なので最初の試作に向きますが、並列化しないため処理時間は短くなりません。
分散型は、各エージェントが自分の判断で次の担当に作業を引き継ぐ構造です。
OpenAI Agents SDKの「ハンドオフ」は、あるエージェントが会話の主導権ごと別のエージェントに渡す仕組みで、受付役が内容を見て専門役に渡す使い方ができます。
柔軟な反面、引き継ぎが往復し続けるループが起きやすいため、引き継ぎ回数の上限や終了条件が欠かせません。
実際のシステムでは、これらを組み合わせることも少なくありません。
例えば、全体は階層型で管理し、統括役の下にいる執筆チームの中だけ逐次型で動かすといった構成です。
迷ったら階層型から始め、並列化の必要がない工程だけ逐次型にすると、制御とスピードのバランスを取りやすくなります。
構造を選ぶ基準は「誰が全体の責任を持つか」を明確にできるかどうかです。
エージェント間の受け渡しを共通ルール(MCP・A2A)でそろえる
エージェント間の受け渡しを共通ルールでそろえるには、AIエージェントと外部ツールをつなぐMCPと、エージェント同士をつなぐA2Aの2つのプロトコル(通信の取り決め)を使い分けます。
1つの社内システムの中で完結する場合は不要なこともありますが、異なるツールや他社製のエージェントを組み合わせるなら押さえておきたい標準です。
| プロトコル | 正式名 | つなぐ対象 | 開発元 |
| MCP | Model Context Protocol | エージェントとツール・データ | Anthropic |
| A2A | Agent2Agent Protocol | エージェントとエージェント |
MCPは、エージェントがデータベースやファイル、業務アプリを呼び出す手順を共通化します。
A2Aは、自分の管理下にない別のエージェントに作業を依頼し、進捗や結果を受け取る手順を共通化します。
A2Aのプロジェクトは、MCPを1体のエージェントの能力を深める「縦」の接続、A2Aを組織をまたいでエージェントをつなぐ「横」の接続と説明しています。
運営面では、GoogleがA2Aを2025年6月にLinux Foundationへ移管し、2026年8月にはMCPと同じLinux Foundation傘下のAgentic AI Foundationで管理されることになりました。
特定の企業に依存しない共通ルールになったことで、異なるベンダーのエージェントを組み合わせやすくなっています。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
マルチエージェントAIの種類
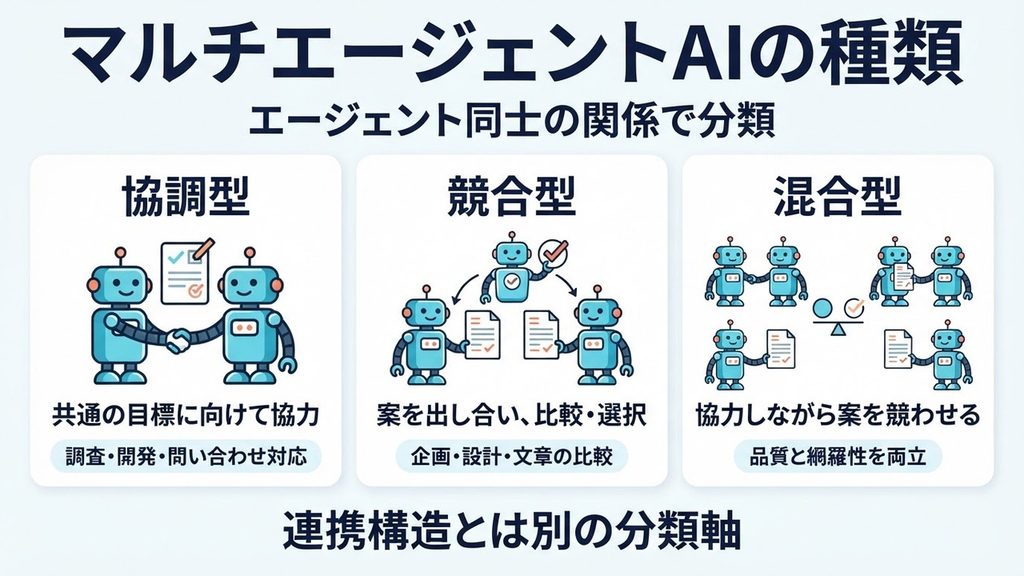
マルチエージェントAIの種類は、エージェント同士の関係によって「協調型」「競合型」「混合型」の3つに分けられます。
業務で使う生成AIのマルチエージェントは協調型が中心で、答えの質を高めたい場面で競合型や混合型の考え方を取り入れます。
| 種類 | エージェント同士の関係 | 業務での使いどころ |
| 協調型 | 共通の目標に向けて分担・協力する | 調査、開発、問い合わせ対応 |
| 競合型 | 別々の案を出し合い、優れた案を選ぶ | 企画案、設計案、文章の比較 |
| 混合型 | 協力しながら、一部の工程で案を競わせる | 品質と網羅性の両方が必要な業務 |
前の見出しの連携構造が「つなぎ方」の分類なのに対し、種類は「エージェント同士がどんな関係にあるか」の分類です。
両者は組み合わせて使えます。
共通の目標に向けて協力し合う「協調型」
協調型は、すべてのエージェントが共通の目標を持ち、役割を分担して協力するマルチエージェントです。
生成AIの業務活用で使われる構成の多くはこの型で、ここまで紹介した統括役・専門エージェント・確認役の連携も協調型にあたります。
協調型が機能する条件は、全体の成功条件が1つに決まっていることです。
例えば「取引先10社の最新の決算情報を表にまとめる」という目標なら、各エージェントは担当企業の情報を集めることに集中し、結果を持ち寄るだけで全体が完成します。
Anthropicのリサーチ機能も、統括役とサブエージェントが「質問に正確に答える」という1つの目標に向かう協調型です。
注意点は、各エージェントが自分の担当では正しく動いていても、全体では重複や待ち時間が生じることです。
複数の担当が同じ資料を検索したり、確認役と作成役が修正のやり取りを終わらせなかったりする例が典型です。
担当ごとの評価基準が全体の成功条件と矛盾していないかを設計時に確かめておくと、協調型の弱点を抑えられます。
協調型は「目標が1つに定まり、作業を分けられる仕事」で最も力を発揮する型です。
互いに競い合ってより良い答えを探す「競合型」
競合型は、複数のエージェントが同じ課題に対して別々の答えを出し、比較や反論を通じてより良い答えを選ぶマルチエージェントです。
1つのAIが出した答えをそのまま使うより、異なる案や反対意見を突き合わせることで、偏りや見落としに気付きやすくなります。
代表的な使い方は2つあります。
1つは、複数のエージェントに案を出させ、評価役が基準に沿って最も良い案を選ぶ方法です。
もう1つは、賛成役と反対役のように立場を分けて議論させ、論点を洗い出す方法で、「ディベート型」と呼ばれることもあります。
評価役を置く場合は、作成役と同じ指示を持たせず評価の基準だけを渡すと、案の良し悪しを公平に比べやすくなります。
業務では、キャッチコピーや企画案の比較、設計方針の検討、契約書のリスクの洗い出しなどに向きます。
研究分野では、ゲームや市場のように利害がぶつかる環境で、相手の行動を読みながら戦略を学ぶマルチエージェント強化学習が競合型の代表例です。
注意点は、議論に終わりがないとコストと時間がかさむことです。
採用の基準と議論の回数の上限を先に決めることが前提で、最終判断は人が行う設計にしておくと安全に使えます。
協力と競争を組み合わせる「混合型」
混合型は、エージェント同士が協力しながら、一部の工程では案を競わせるマルチエージェントです。
網羅性と品質の両方が求められる業務で、協調型と競合型の弱点を補い合えます。
例えば記事制作なら、調査役と構成役は協調して情報を集め、執筆の段階では2体の執筆役が別々の下書きを作り、評価役が基準により合う方を選ぶ、といった構成になります。
調査は分担した方が速く、表現は比べた方が良いものを選べるため、工程ごとに関係を変えるわけです。
比べる案は2〜3案にとどめ、評価の基準を事前に文章で決めておくと、評価役の判断がぶれにくくなります。
研究分野では、チーム内では協力し、チーム同士では競い合うサッカーのような環境が混合型の典型です。
マルチエージェント強化学習では、こうした協力と競争が混ざった環境での学習も研究されています。
混合型は設計の自由度が高い分、エージェントの数と処理の回数が増えやすい型です。
競わせる工程は「品質の差が成果に直結する部分」だけに絞ると、コストを抑えながら効果を得られます。
最初から混合型を組むより、協調型で動かしてから競わせる工程を足す方が失敗しにくい進め方です。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
マルチエージェントシステムの実用例
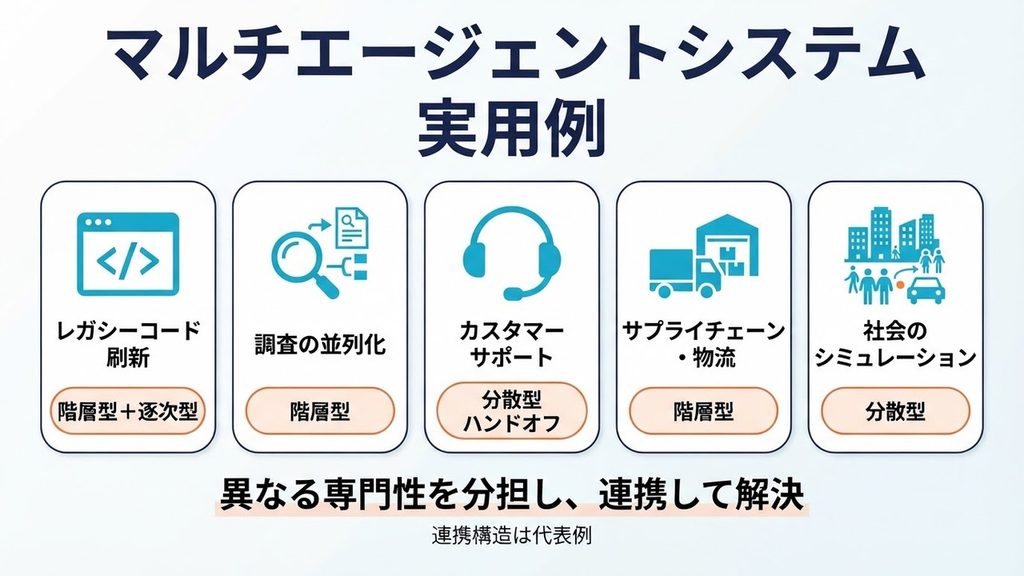
マルチエージェントシステムの実用例は、レガシーコードの刷新、調査の並列化、カスタマーサポート、サプライチェーン・物流、社会のシミュレーションの5つが代表的です。
共通するのは、作業を独立した単位に分けられ、工程ごとに必要な情報や専門性が違う点です。
| 実用例 | 主な連携構造 | マルチエージェントにする理由 |
| レガシーコードの刷新(Siemens×Google Cloud) | 階層型+逐次型 | 巨大なコードベースを1体では扱いきれない |
| 調査の並列化(Anthropic) | 階層型 | 調べる方向を並列に進めて時間を短縮する |
| カスタマーサポート | 分散型(ハンドオフ) | 問い合わせごとに必要な知識と権限が違う |
| サプライチェーン・物流 | 階層型 | 拠点ごとの条件を調整しながら全体の計画を作る |
| マルチエージェントシミュレーション | 分散型 | 多数の主体の相互作用から全体の動きを再現する |
前半2つは企業が仕組みと結果を公開している事例、後半3つは業界で導入や検討が進む代表的な使い方です。
自社の業務に近い例から読むと、試す範囲を具体的に描きやすくなります。
レガシーコードの刷新を専門エージェントで分担する(Siemens×Google Cloud)
Siemensは、Google Cloudと共同で、レガシーコードの理解と刷新を専門エージェントで分担するAIシステム「Knowledge Fabric」を構築しました。
複雑なリファクタリングを小さなタスクに切り分けて専門エージェントに任せる方法を「象の切り分け(slicing the elephant)」と名付けています。
背景には、10年以上かけて開発された数億行規模のコードベースがありました。
必要な知識はコード、Jiraのチケット、Confluenceのページ、2000年代初頭にスキャンしたPDFマニュアルに散らばり、LLMが一度に扱える量を大きく超えていました。
Knowledge Fabricでは、Google Agent Development Kit(ADK)で作った5つの専門エージェントが分担します。
| エージェント | 担当 |
| 検索エージェント | コードの関係を表したナレッジグラフを探索し、文書と照合する |
| ユーザーストーリーエージェント | 製品担当者から要件を聞き取り、受け入れ基準を含む下書きを作る |
| アーキテクチャ影響エージェント | 変更案が既存システムに与える副作用を事前に予測する |
| タスク分解エージェント | 影響分析をもとに、作業を小さなタスクに分ける |
| コーディングエージェント | 分解されたタスクに沿って変更を実装する |
すべての工程に人が関与する設計で、新機能の依存関係の分析は、以前はシニアエンジニアが数日かけていた作業が大幅に短くなったと公表されています。
旧式の操作パネルをWebの画面に移す試験運用でも、品質基準を保ったままコーディング作業が減りました。
同社は、AIエージェントが大規模で曖昧なタスクを苦手とすることがプロジェクトの重要な学びだったとしています。
再現の条件は、コードと文書の関係をグラフで整理し、エージェントに渡す文脈を事前に用意できることです。
大きな仕事をそのまま渡さず、分析と分解を担うエージェントを実装役の前に置く点が、自社で応用しやすいポイントです。
調査テーマを複数のエージェントで並列に深掘りする(Anthropicのリサーチ機能)
Anthropicは、Claudeのリサーチ機能で、調査テーマを複数のサブエージェントに分けて並列に深掘りするマルチエージェント構成を採用しています。
統括役のエージェントが質問を分析して調査計画を立て、テーマの側面ごとにサブエージェントを起動し、各サブエージェントが同時にWeb検索を進めます。
並列化の効果は数字で公開されています。
統括役が3〜5体のサブエージェントを同時に起動し、各サブエージェントも3つ以上のツールを並列に使うようにした結果、複雑な調査で所要時間が最大90%短くなりました。
社内評価では、マルチエージェント構成が単体のClaude Opus 4を90.2%上回っています。
一方で、運用の中で課題も見つかりました。
初期のエージェントは、単純な質問に50体のサブエージェントを起動したり、存在しない情報源を探し続けたりしました。
そこで同社は、質問の複雑さに応じて規模を変えるルールをプロンプトに組み込みました。
単純な事実確認は1体で3〜10回のツール呼び出し、比較なら2〜4体、複雑な調査なら10体以上という目安です。
同社によると、マルチエージェント構成が特に強いのは、互いに独立した方向を同時に調べる「幅優先」の質問です。
再現の条件は、調べる方向が互いに独立していて、成果物の価値が増えるコストに見合うことです。
エージェントの数を固定せず、質問の複雑さで増減させるルールを持たせることが、この事例から学べる設計のポイントです。
問い合わせの内容に応じて担当エージェントへ振り分ける(カスタマーサポート)
カスタマーサポートでは、受付役のエージェントが問い合わせの内容を判断し、請求、技術サポート、予約変更などの担当エージェントに振り分ける構成が使われます。
問い合わせの種類ごとに必要な知識と操作権限が違うため、1体に全部を持たせるより、担当を分けた方が回答の精度と安全性を保ちやすくなります。
この振り分けは、OpenAI Agents SDKの「ハンドオフ」で実装できる代表的なパターンです。
受付役が問い合わせを読んで適切な担当に会話ごと引き継ぎ、担当エージェントは自分の領域の情報とツールだけを使って対応します。
担当で解決できない場合は、人のオペレーターに引き継ぐ流れを組み込みます。
| 担当 | 参照する情報 | 許可する操作の例 |
| 受付役 | 問い合わせを分類するルール | 担当への振り分けのみ |
| 請求担当 | 料金表、契約情報 | 請求内容の照会 |
| 技術担当 | 製品マニュアル、障害情報 | 手順の案内、チケットの起票 |
返金や契約変更のように取り消しにくい操作は、AIだけで完結させず人の承認を挟むことが前提です。
担当ごとに「見られる情報」と「できる操作」を分けられることが、サポート業務でマルチエージェントを使う最大の理由です。
在庫や配送の計画を拠点ごとのエージェントで調整する(サプライチェーン・物流)
サプライチェーン・物流では、需要予測、在庫、配送計画、拠点ごとの状況をそれぞれのエージェントが担当し、全体の計画を調整する使い方が検討されています。
拠点や工程ごとに見るべきデータと判断基準が違うため、担当を分けて調整役がまとめる階層型と相性の良い分野です。
例えば、各倉庫の在庫担当エージェントが欠品のリスクを報告し、配送担当が交通や天候の情報から遅延の可能性を出し、調整役が納期や契約条件と照らして配送計画の候補を作る、といった流れです。
人の担当者は候補と根拠を確認して最終判断をします。
実際の導入も始まっています。
DHL Supply Chainは、配送の予約調整、ドライバーへのフォローアップ、優先度の高い倉庫の調整にAIエージェントを使っていると2025年に公表しました。
ただし、この事例で複数のエージェントがどう連携しているかまでは公開されていません。
需要予測や配送の可否には誤差がつきものです。
計画を自動で確定させず、根拠と更新日時を示して人が変更できる運用にしておくと、例外が起きたときにも対応できます。
交通や市場の動きをマルチエージェントシミュレーションで再現する
交通や市場の動きを再現する用途では、マルチエージェントシミュレーションが使われます。
人、車、企業などを1体ずつエージェントとしてモデル化し、条件を変えながら全体がどう動くかを比べることで、実際には試せない施策の影響を事前に検討できます。
交通分野では、ドライバー1人ひとりの経路選択をエージェントで表し、道路工事や信号の変更が渋滞にどう影響するかを比較します。
市場分野では、売り手と買い手をエージェントにして、価格の変化や規制の影響を再現します。
避難計画の検討でも群衆の動きをシミュレーションで確かめる研究が行われており、オープンソースのGAMA Platformでは都市の避難行動を扱うプロジェクトが公開されています。
生成AIとの組み合わせも進んでいます。
2023年に発表された研究「Generative Agents」では、LLMで動く25体のエージェントが仮想の町で生活し、パーティーの告知が住民の間で自然に広まる様子が観察されました。
シミュレーションの結果は、入力した前提に強く左右されます。
結果を予測そのものとして扱わず、前提条件とあわせて「比較の材料」として使うことが、意思決定に生かすうえでの前提です。
マルチエージェントは、作業を独立した単位に分けられる業務で成果が出ています。
自社の業務がどの事例に近いかを確かめたい場合は、下記から相談できます。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
マルチエージェントを使うメリット
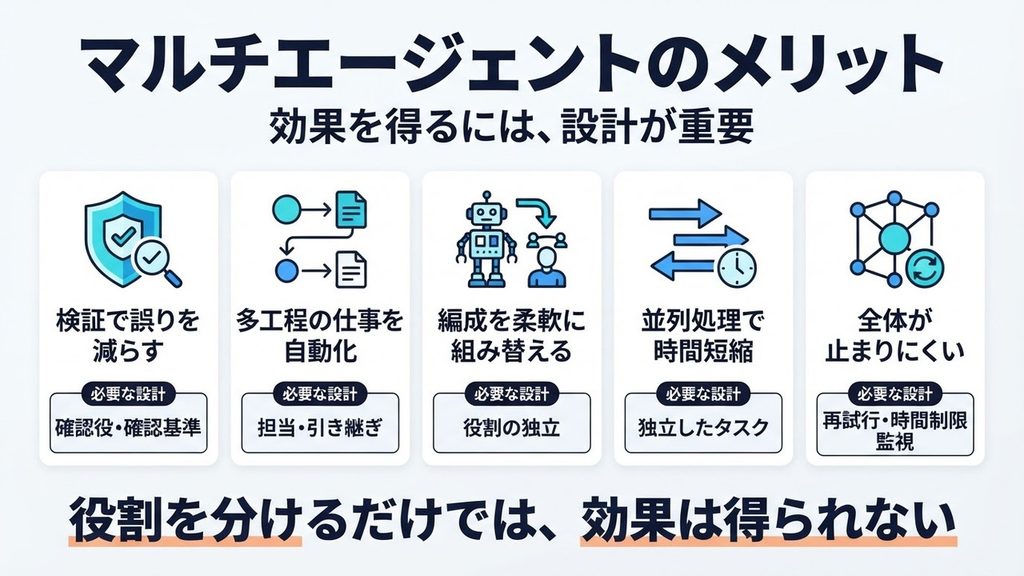
マルチエージェントを使うメリットは、検証で誤りを減らせること、工程の多い仕事を自動化しやすいこと、編成を組み替えられること、並列処理で速くなること、全体が止まりにくい設計にできることの5つです。
いずれも「役割を分けたことで得られる効果」で、設計しなければ自動的には得られません。
| メリット | 得られる効果 | 前提になる設計 |
| 検証で誤りを減らせる | ハルシネーションや論理の破綻を拾える | 確認役と確認の基準 |
| 工程の多い仕事を自動化しやすい | 開発や長文の調査を通しで任せられる | 工程ごとの担当と引き継ぎ |
| 編成を組み替えられる | 業務の変化に合わせて担当を追加・交換できる | 役割ごとに独立した設計 |
| 処理時間を短縮できる | 独立した作業を同時に進められる | 並列化できるサブタスク |
| 全体が止まりにくい | 一部の失敗を再実行や代替で補える | 再試行・タイムアウト・監視 |
表の右列の設計が欠けていると、メリットは得られません。
メリットとセットで「何を設計すれば得られるか」を確認することが、導入後の期待外れを防ぎます。
別のエージェントの検証でハルシネーションや論理の破綻を減らせる
別のエージェントに検証を任せると、作成役が見落としたハルシネーション(もっともらしい誤情報)や論理の破綻を拾いやすくなります。
人間でも自分の文章の誤りには気付きにくいのと同じで、作成と検証を同じAIが続けて行うと、最初の思い込みを引きずりやすいためです。
検証役を分ける効果が出やすいのは、確認の基準を明確に書ける場合です。
例えば次のような基準です。
- 主張ごとに出典があり、出典の内容と一致しているか
- 計算や数値が元のデータと合っているか
- 社内規程や契約条件と矛盾していないか
- コードがテストを通り、既存の動作を壊していないか
Anthropicのリサーチ機能では、出典を照合する専用のCitationAgentを置いています。
また同社は評価の段階で、事実の正確さや出典の正確さなどの基準でLLMに採点させる「LLM-as-judge」を使い、数百件の出力を評価したと公表しています。
注意点は、検証役も同じ種類の誤りをする可能性があることです。
検証役には作成役と違う情報源や手段(検索、計算ツール、テストの実行)を持たせると、確認の効果が上がります。
AIを2体並べるだけでは誤りは減らず、「別の手段で確かめる」設計が必要です。
開発や長文調査など工程の多い仕事を自動化しやすい
開発や長文の調査のように工程が多い仕事は、工程ごとに担当エージェントを置くことで、最初から最後まで通しで自動化しやすくなります。
1体のAIに全工程を任せると、途中で集めた情報が増えるほど指示や前提を取りこぼしやすくなるためです。
AIが一度に扱える情報量(コンテキストウィンドウ)には上限があり、長い作業ほど古い情報が押し出されます。
マルチエージェントでは、各担当が自分の工程に必要な情報だけを持つため、この問題を避けられます。
Claude Codeのサブエージェントも、メインの会話とは別のコンテキストで動き、結果だけを返す仕組みです。
例えば新機能の開発なら、要件整理役、設計役、実装役、テスト役に分けられます。
Siemensの事例では、実装の前に影響分析とタスク分解を担うエージェントを置くことで、数億行のコードベースでも作業を進められるようにしていました。
工程ごとに完了条件を決め、条件を満たしたら次に渡す形にすると、人が途中で確認する箇所も明確になります。
工程の区切りが「AIの担当の区切り」と「人の確認の区切り」を兼ねるのが、工程の多い仕事でマルチエージェントを使う利点です。
業務の変化に合わせてチームの編成を組み替えられる
マルチエージェントは役割ごとにエージェントが独立しているため、業務の変化に合わせて担当を追加・交換・削除しやすいというメリットがあります。
1体のAIに長い指示を書き足し続ける方法と比べて、変更の影響範囲を小さく保てます。
例えば問い合わせ対応で新製品の窓口が必要になったら、新製品担当のエージェントを1体追加し、受付役の振り分けルールに1行加えるだけで済みます。
ほかの担当の指示には手を入れません。
精度の高い新しいモデルが出たときも、検証役だけ新しいモデルに替える、といった部分的な更新ができます。
コストの面でも組み替えは効きます。
Claude Codeでは、サブエージェントごとに使うモデルを指定でき、軽い作業を高速で安価なモデルに任せてコストを抑えられます。
組み替えやすさを保つには、各エージェントの入力と出力の形式を決めておくことが条件です。
形式がそろっていれば、担当を入れ替えても前後のエージェントに影響が出ません。
エージェントを「交換できる部品」として設計しておくことが、長く運用するための鍵になります。
独立した作業を並列で進めて処理時間を短縮できる
独立した作業を複数のエージェントで同時に進めれば、1体で順番に処理するより全体の処理時間を短くできます。
調べる対象が多い調査や、ファイルごとに独立したテストの作成などで効果が大きいメリットです。
Anthropicのリサーチ機能では、サブエージェントの並列起動と、各サブエージェント内でのツールの並列実行を取り入れたことで、複雑な調査の所要時間が最大90%短くなりました。
GitHub Copilot CLIにも、作業を複数のサブエージェントに分けて並列に進める機能があります。
ただし、並列化で速くなるのは、作業同士が互いの結果を待たずに進められる場合だけです。
前の工程の結果がないと次に進めない作業は、エージェントを増やしても速くならないため、並列化できる部分を見極めてから構成を決めます。
複数の言語への翻訳や、競合企業ごとの情報収集のように、対象ごとに作業が完結する仕事が並列化の典型です。
なお、同時に動かすエージェントが増えるほど一度に消費するトークンも増えるため、並列数の上限も決めておきます。
一部のエージェントが止まっても全体が止まりにくい
マルチエージェントは担当が分かれているため、一部のエージェントが失敗しても、その担当だけを再実行したり別の担当に任せたりして、全体を止めずに処理を続ける設計にできます。
1体のAIが長い作業の途中で失敗すると、最初からやり直しになりやすいのと対照的です。
Anthropicは、エラーが起きたときに最初から再起動するのではなく、エラーが起きた地点から再開できる仕組みを作ったと公表しています。
ツールが失敗していることをエージェントに伝えて対応させる方法と、再試行や定期的なチェックポイント(途中保存)といった決まった処理を組み合わせています。
また同社は、稼働中のエージェントを止めずに更新するため、新旧のバージョンを並行して動かしながら少しずつ切り替える方法をとっています。
ただし、マルチエージェントにするだけで障害に強くなるわけではありません。
再試行、タイムアウト、途中保存、監視アラートを実装して初めて止まりにくい仕組みになります。設計とセットで得られるメリットとして捉えてください。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
マルチエージェントのデメリット
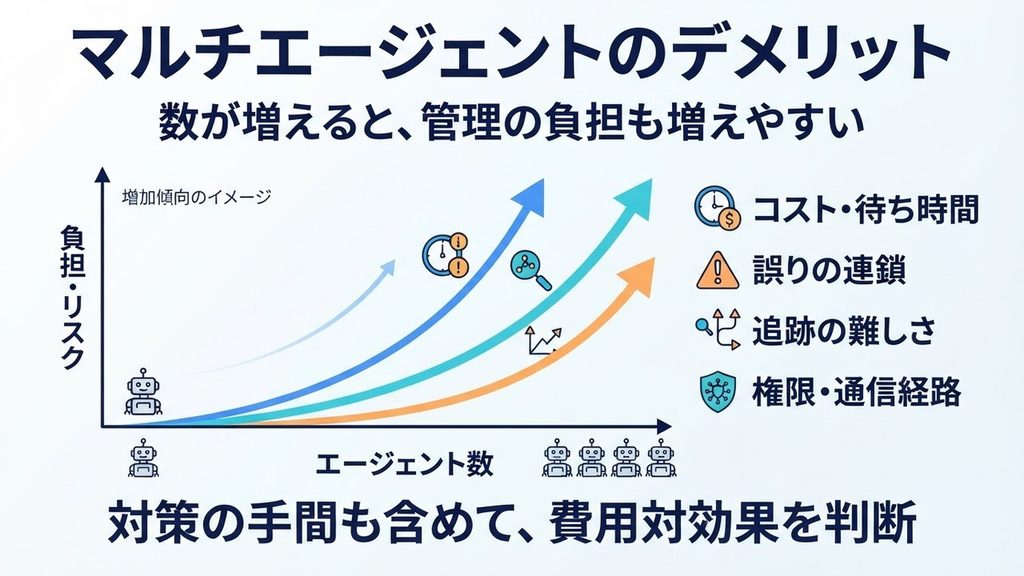
マルチエージェントのデメリットは、コストと待ち時間の増加、誤りの連鎖、問題の追跡のしにくさ、セキュリティ管理の複雑化の4つです。
どれもエージェント同士のやり取りが増えることから生じるため、エージェントの数を増やすほど影響が大きくなります。
| デメリット | 起きること | 主な対策 |
| コストと待ち時間が増える | トークン消費がチャットの約15倍になる例もある | 使う業務を絞る、軽いモデルを併用する |
| 誤りが連鎖しやすい | 前工程の誤りを後工程が前提にしてしまう | 引き継ぎ時の検証、途中での人の確認 |
| 追跡・デバッグしにくい | 実行のたびに経路が変わり、原因を特定しにくい | 全工程のトレース(実行記録) |
| セキュリティ管理が複雑になる | 権限と通信経路が増え、攻撃や漏えいの入口も増える | 最小権限、承認、監査ログ |
メリットが得られる業務でも、この4つの対策の手間を含めて採算が合うかを比べることが、導入判断の出発点です。
4つのうちコストは試作の段階ですぐに見える一方、誤りの連鎖やセキュリティの問題は運用を始めてから表面化しやすい点にも注意が必要です。
シングルエージェントより利用コストと待ち時間が増える
マルチエージェントは、エージェント同士のやり取りの分だけ処理量が増えるため、シングルエージェントより利用コストと待ち時間が増えます。
生成AIの利用料は処理したトークン(文字の単位)の量で決まることが多く、エージェントが増えるほど直接料金に響きます。
Anthropicの公開データでは、エージェントはチャットの約4倍、マルチエージェント構成は約15倍のトークンを使います。
同社は、マルチエージェントが成り立つのは性能の向上に見合うほど価値の高い仕事だとしています。
また同社の分析では、Web調査の評価で成績の違いの80%がトークンの使用量だけで説明でき、マルチエージェントは「より多くのトークンを使えること」で性能を上げている面があります。
待ち時間も増えます。
同社のリサーチ機能では、統括役がサブエージェントの完了を待ってから次に進むため、1体の検索が長引くとシステム全体が待たされるという課題が挙げられています。
対策としては次の方法があります。
- 単純な依頼は1体で処理し、複雑なものだけマルチエージェントに回す
- 検索や要約など軽い作業は高速で安価なモデルに任せる
- 最大の呼び出し回数やタイムアウトを決めておく
マルチエージェントのコストは「成果物1件あたりの価値」と比べて判断するのが基本です。
同じ仕事をシングルエージェントで処理した場合の費用と時間を、試行の段階で必ず並べて比べてください。
1つの誤りが後続のエージェントに連鎖しやすい
マルチエージェントでは、1つのエージェントの誤りが後続のエージェントに引き継がれ、連鎖的に結果を歪めやすくなります。
後ろの担当は前の担当の出力を前提に作業するため、最初の誤りを疑わずに積み上げてしまうからです。
Anthropicは、エージェントは状態を持ちながら長く動くため、エラーが積み重なると説明しています。
従来のソフトウェアなら小さな不具合で済む問題でも、エージェントでは1つの手順の失敗が全く違う経路の探索につながり、予測できない結果を招くことがあるといいます。
例えば、調査役が古い統計を拾うと、分析役はその数字で計算し、執筆役はその分析をもとに結論を書きます。
その結果、誤った結論が根拠付きのように見える成果物ができあがります。
対策は、引き継ぎのたびに最低限の検証を挟むことです。
数値には出典と取得日を必ず付けて渡す、重要な分岐点では人が確認する、といったルールを置きます。
Anthropicも、成果物を統括役経由ではなく共有の保存先経由で受け渡すことで、伝言ゲームのような情報の欠落を減らしています。
誤りを「最後にまとめて見つける」のではなく「渡す時点で止める」設計が、連鎖を防ぐ基本です。
どこで問題が起きたのか追跡・デバッグしにくい
マルチエージェントは、どのエージェントのどの判断で問題が起きたのかを追跡しにくく、デバッグに手間がかかります。
エージェントは実行のたびに違う手順を選ぶことがあり、同じ指示でも結果が変わるため、不具合を再現すること自体が難しいからです。
Anthropicも、利用者から「明らかな情報を見つけられない」という報告を受けても、検索語が悪いのか、情報源の選び方が悪いのか、ツールが失敗したのか、原因がすぐには分からなかったと明かしています。
同社は本番環境の処理を全工程記録するトレース(実行記録)を加え、失敗の原因を体系的に突き止められるようにしました。
会話の中身ではなく、エージェントの判断の傾向ややり取りの構造を監視することで、利用者のプライバシーを守りながら原因を調べているといいます。
記録しておくべき項目の例は次のとおりです。
- どのエージェントが、いつ、どんな指示を受けたか
- どのツールを、どんな入力で呼び出したか
- 次の担当に何を渡したか
トレースの仕組みは後から足すより、最初の試作から入れておく方が手間がかかりません。
OpenAI Agents SDKのように、トレース機能を標準で備えたフレームワークを選ぶのも有効です。
権限や通信経路が増えてセキュリティ管理が複雑になる
マルチエージェントでは、エージェントごとに権限や通信経路が増えるため、セキュリティ管理が複雑になります。
外部のツールやデータに触れる入口が増えるほど、情報漏えいや不正な操作が起きる可能性のある場所も増えるからです。
特に注意したいのが、Webページや文書に紛れ込ませた指示でAIの動作を乗っ取る「プロンプトインジェクション」です。
調査役が読み込んだ悪意あるページの指示が、引き継ぎを通じて書き込み権限を持つ別のエージェントに届くと、被害が広がるおそれがあります。
基本の対策は次の4つです。
- 最小権限:各エージェントには担当に必要な権限だけを与える
- 承認:送信、削除、支払いなど取り消しにくい操作は人が承認する
- 監査ログ:誰が何にアクセスし、何をしたかを記録する
- 外部送信の制限:社外に送れるデータの範囲を決めておく
Claude Codeのサブエージェントでも、各担当の役割に必要な最小限の権限だけを与えることが推奨されています。
エージェントを増やすたびに、権限の一覧を更新する運用を決めておくと、管理が追いつかなくなる事態を防げます。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
マルチエージェントを使うべきか見極める判断基準
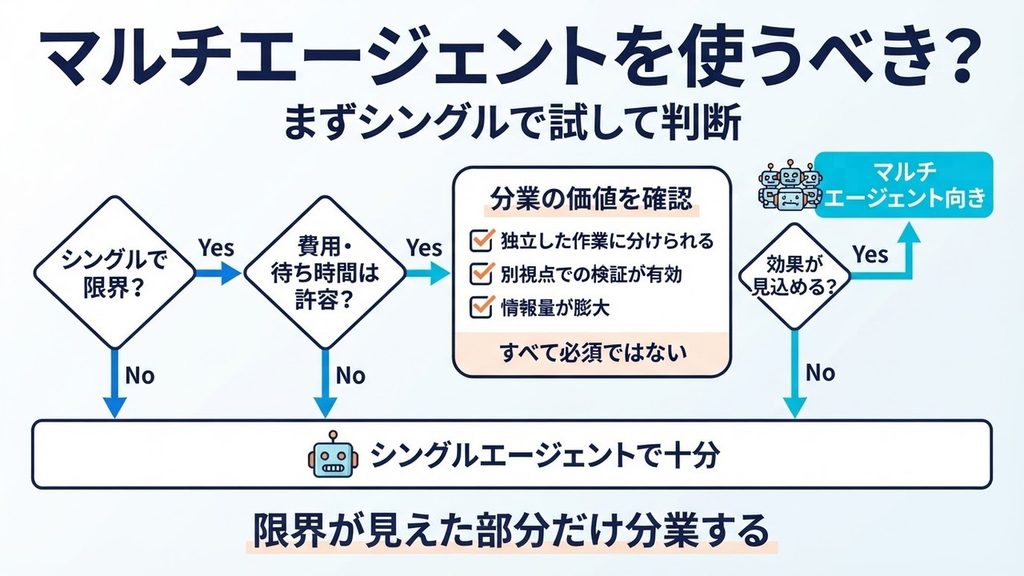
マルチエージェントを使うべきかは、作業を独立したサブタスクに分けられるか、別視点の検証に価値があるか、1体で扱えない情報量か、コストと待ち時間を許容できるか、シングルエージェントで限界が見えているか、の5つで判断できます。
当てはまる数が多いほどマルチエージェントの効果が出やすく、少なければシングルエージェントで十分です。
| 判断基準 | Yesならマルチエージェント向き | Noならシングルエージェントで十分 |
| 独立したサブタスクに分けられるか | 調べる方向や作業が互いに独立している | 前の結果がないと次に進めない |
| 別視点の検証に価値があるか | 誤りが外に出たときの影響が大きい | 多少の誤りは人が直せば済む |
| 1体で扱えない情報量か | 資料やコードが膨大 | 1回の指示に収まる |
| コストと待ち時間を許容できるか | 成果物1件の価値が高い | 即答や大量の安価な処理が必要 |
| シングルで限界が見えているか | 試した結果、精度や処理量が足りない | まだ試していない |
5つすべてを満たす必要はありませんが、4つ目のコストと5つ目の限界の確認は外さないでください。
まずシングルエージェントで試し、限界が見えた部分だけを分業するのが、無駄のない導入の順番です。
作業を互いに独立したサブタスクに分けられるか
マルチエージェントを使うべきかの最初の判断基準は、作業を互いに独立したサブタスクに分けられるかどうかです。
サブタスク同士が互いの結果を待たずに進められるほど、並列化と分業の効果が大きくなります。
独立しているかを見分けるには、「このサブタスクだけを別の担当者に渡したら、ほかの作業の結果を見ずに終えられるか」を考えます。
| 業務 | 独立性 | 理由 |
| 競合10社の価格と機能の調査 | 高い | 1社ずつ別々に調べられる |
| 複数の言語への翻訳 | 高い | 言語ごとに作業が完結する |
| 1本の企画書の執筆 | 低い | 前の章の内容が後の章に影響する |
| 1つの不具合の原因調査 | 低い | 1つの手がかりから次の調査が決まる |
Anthropicも、エージェント間の依存関係が多い仕事や、全員が同じ文脈を共有しなければならない仕事は、現時点でマルチエージェントに向かないとしています。
多くのコーディング作業は調査ほど並列化できず、エージェント同士がリアルタイムで調整し合うことはまだ得意ではない、というのが同社の見解です。
独立性が低い業務でも、工程の一部だけは切り出せることがあります。
企画書なら、執筆は1体で行い、市場データの収集だけを並列に任せるといった分け方です。
業務全体ではなく「切り出せる部分があるか」で判断すると、使いどころが見つかりやすくなります。
生成物を別の視点で検証する価値がある業務か
2つ目の判断基準は、生成物を別の視点で検証する価値がある業務かどうかです。
誤りが外に出たときの影響が大きい業務ほど、検証役を置くマルチエージェントの効果が高くなります。
検証の価値が高いのは、顧客や取引先に直接届く文書、公開する記事や資料、金額や数値を扱う資料、本番環境に反映するコードなどです。
誤りが見つかったときの修正コストや信用への影響が大きいため、検証役のコストを払う意味があります。
反対に、社内の議事録の下書きや、アイデア出しのたたき台のように、人が読んで直すことが前提の成果物では、検証役を置いても効果は限られます。
人が最終確認するなら、AIの検証役はその手前の作業を減らす程度の役割です。
AIの検証役が数値の不一致や出典の欠落といった形式的な誤りを先に取り除き、人は内容が妥当かの判断に集中する、という分担が現実的です。
判断に迷ったら、過去に人が手作業で見つけた誤りの種類と件数を振り返ってみてください。
確認に時間がかかっている業務ほど、検証役で減らせる余地があります。
「誤りが出たら誰が困るか」がはっきりしている業務ほど、検証役を置く価値があります。
1つのエージェントでは扱いきれない情報量か
3つ目の判断基準は、扱う情報が1つのエージェントでは扱いきれない量かどうかです。
資料やコードが1体のAIが一度に保持できる量を超える場合、担当を分けてそれぞれに必要な部分だけを渡すマルチエージェントが有効になります。
Anthropicは、マルチエージェントが特に力を発揮する仕事の条件の1つに、1つのコンテキストウィンドウに収まらない情報を扱うことを挙げています。
同社のリサーチ機能でも、統括役のコンテキストが20万トークンを超えると内容が切り捨てられるため、計画をメモリに保存してから作業を分担しています。
Siemensの事例も、数億行のコードベースと、チケットや古いPDFマニュアルに散らばった知識を扱うために、検索役やタスク分解役を分けています。
一方、1回の指示に収まる量の資料なら、分割する必要はありません。
反対に、情報量が多くても、1つの文書を頭から順に読み解く必要がある場合は、分割すると文脈が切れて精度が落ちることがあります。
読み込ませる資料の総量と、1体で処理したときに抜けや混乱が起きるかを実際に試して確かめるのが確実です。
コストの増加と待ち時間を許容できる業務か
4つ目の判断基準は、コストの増加と待ち時間を許容できる業務かどうかです。
マルチエージェントはシングルエージェントより多くの処理を行うため、成果物1件あたりの価値が増えるコストを上回ることが条件になります。
許容しやすいのは、1件の成果物に人が何時間もかけている業務です。
例えば、数日かかる市場調査や、シニアエンジニアが数日かけていた依存関係の分析は、AIの利用料が増えても人の作業時間の削減の方が大きくなりやすい業務です。
許容しにくいのは、即答が求められる業務や、大量に処理する単価の低い業務です。
チャットでの一問一答や、1件あたり数秒で済む分類作業にマルチエージェントを使うと、待ち時間とコストが増えるだけで、利用者の満足度が下がるおそれがあります。
Anthropicも、マルチエージェントは性能の向上に見合う価値の高い仕事に限るべきだとしています。
目安を出すには、1件あたりの利用料、処理時間、人が確認にかける時間をシングルエージェントと比べます。
「速くて安い」ではなく「高くても価値が上がる」業務がマルチエージェントの対象です。
シングルエージェントで精度や処理量の限界が見えているか
5つ目の判断基準は、シングルエージェントで試した結果、精度や処理量の限界が見えているかどうかです。
マルチエージェントは複雑さが増す分、シングルエージェントで十分な成果が出る業務に使うと、手間とコストだけが増えます。
限界のサインには次のようなものがあります。
- 長い指示を書いても、一部の指示が守られない
- 資料が多くなると、前半の内容を忘れたような回答になる
- 調査の抜けが多く、人が追加で調べ直している
- 処理件数が多く、順番に処理すると時間が足りない
こうしたサインが出たら、問題が起きている部分だけを切り出して別のエージェントに任せます。
いきなり全体をマルチエージェントに作り替えるのではなく、限界が見えた工程から1体ずつ追加する方が、効果とコストの関係を確かめやすくなります。
限界かどうかは感覚ではなく、同じ評価用の依頼で正答率や処理時間を測って判断すると、マルチエージェントにした後の比較にもそのまま使えます。
まだシングルエージェントで試していないなら、まずそこから始めるのが近道です。
指示の工夫やツールの追加だけで解決することも少なくありません。
5つの基準のうち、コストと限界は自社の業務で試さないと分かりません。
判断基準に当てはめて対象業務を絞り込みたい場合は、下記から相談できます。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
マルチエージェントAIの開発・利用に使える主要ツール7選
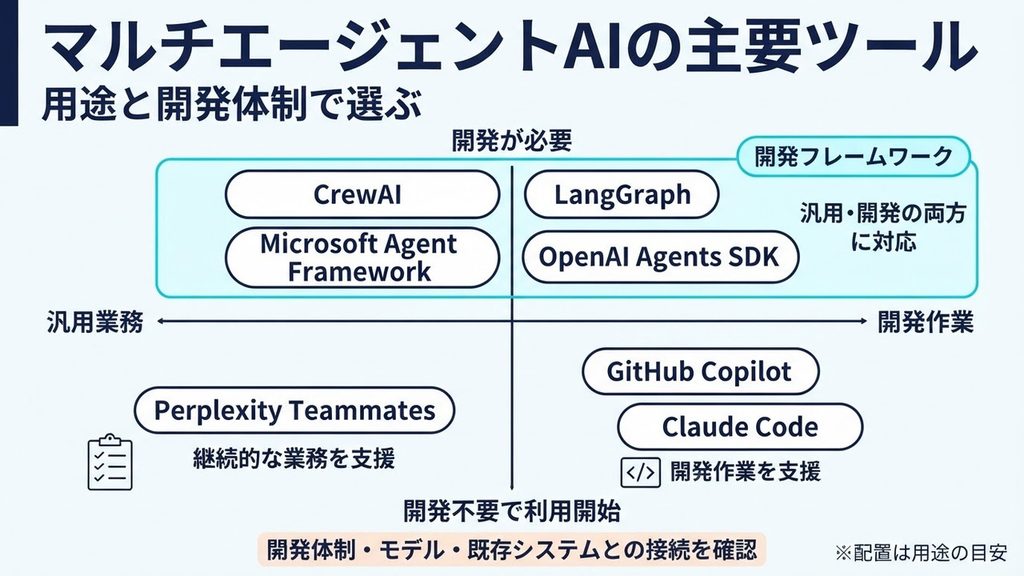
マルチエージェントAIの開発・利用に使える主要ツールは、自分で組み立てる開発フレームワーク(CrewAI、LangGraph、Microsoft Agent Framework、OpenAI Agents SDK)と、すぐに使えるサービス(GitHub Copilot、Claude Code、Perplexity Teammates)に分かれます。
エンジニアがいて自社の業務に組み込みたいならフレームワーク、まず体験したい・開発作業で使いたいならサービスから選ぶのが近道です。
| ツール | 種類 | 向いている人 | 特徴 |
| CrewAI | 開発フレームワーク | 役割分担型のチームを手早く組みたい開発者 | 役割・タスク・進め方で構成を書ける |
| LangGraph | 開発フレームワーク | 分岐や状態を細かく制御したい開発者 | 処理の流れをグラフで定義できる |
| Microsoft Agent Framework | 開発フレームワーク | Microsoft環境で本番運用したい企業 | AutoGenの後継として案内されている |
| OpenAI Agents SDK | 開発フレームワーク | ChatGPTと同じモデルで作りたい開発者 | ハンドオフとトレースを標準で備える |
| GitHub Copilot | サービス | 開発作業を分担させたいエンジニア | VS CodeとCLIでサブエージェントを使える |
| Claude Code | サービス | 開発作業を分担させたいエンジニア | 役割ごとのサブエージェントを定義できる |
| Perplexity Teammates | サービス | 継続的な業務をAIに任せたいビジネス職 | 目標を分解して複数のエージェントで並列実行する |
選ぶときは、プログラミングの体制、使いたいモデル、既存システムとの接続の3点を確認します。
フレームワークはPythonなどでの開発が前提で、自由度が高い分、権限やログの設計も自分で行います。
サービスは設定だけで使い始められますが、構成の自由度は限られます。
同じフレームワークでも、得意な連携構造は異なります。
役割から組み立てたいならCrewAI、処理の流れと状態から組み立てたいならLangGraph、受付から担当への引き継ぎを中心に組みたいならOpenAI Agents SDKが候補です。
ツールの機能や提供条件は更新が速いため、導入前には各公式サイトで最新の情報を確認してください。
ツールを先に選ぶのではなく、試したい業務と体制を決めてから選ぶと、乗り換えの手間を減らせます。
CrewAI
CrewAIは、役割を持つエージェントとタスクを組み合わせ、人間のチームのような分業を短いコードで組めるPythonのフレームワークです。
マルチエージェントを初めて実装する開発者でも、構成を直感的に書けるのが特徴です。
CrewAIでは、エージェントごとに役割と目標を設定し、タスクを割り当てて「クルー(チーム)」としてまとめます。
タスクを順番に実行するか、管理役のエージェントに割り振らせるかといった進め方(プロセス)を選べるため、逐次型と階層型のどちらの構成も作れます。
さらに、処理の流れを細かく制御する「フロー」も用意されています。
例えば、市場調査役、分析役、レポート作成役の3体を定義し、調査→分析→作成の順に動かす、といった構成を少ないコードで書けます。
注意点は、役割と目標を書くだけで安定して連携するわけではないことです。
各タスクの出力形式、使えるツール、確認の手順まで決めて初めて、毎回同じ品質で動く構成になります。
役割分担のイメージを素早く形にして試す用途に向いたフレームワークです。
詳しくはCrewAI公式サイトをご覧ください。
LangGraph
LangGraphは、エージェントの処理の流れをグラフ(点と矢印)として定義し、状態や分岐を細かく制御できるフレームワークです。
LangChainを開発する企業が提供しており、本番運用を前提にした構成を作りたい開発者に向いています。
LangGraphでは、各処理を「ノード」、処理のつながりを「エッジ」として書き、処理中のデータを「状態」として管理します。
条件によって次の担当を変える分岐、失敗時のやり直し、人の承認を待つ処理なども、どの状態で何をするかを明示して組み込めます。
統括役が担当を選ぶ型や、エージェント同士の引き継ぎ(ハンドオフ)といったマルチエージェントの型も扱えます。
CrewAIが「役割から考える」ツールだとすれば、LangGraphは「流れと状態から考える」ツールです。
入力形式、出力形式、停止条件を明示したい業務では、この設計の細かさが品質の安定につながります。
一方で、分岐や再試行を増やすほどテストすべき範囲も広がります。
自由度が高い分、エラー処理とログの設計を先に決めてから実装することが、使いこなすための前提です。
詳しくはLangGraph公式サイトをご覧ください。
Microsoft Agent Framework(旧AutoGen)
Microsoft Agent Frameworkは、Microsoftが提供するAIエージェント開発のフレームワークで、マルチエージェントの代表的なフレームワークとして知られたAutoGenの後継にあたります。
AutoGenの公式リポジトリでは、AutoGenは新機能の追加を止めた保守モードとされ、新しいプロジェクトにはMicrosoft Agent Frameworkが案内されています。
AutoGenは、複数のエージェントが会話しながら課題を解く構成を早くから提供し、マルチエージェントの研究や試作で広く使われてきました。
Microsoft Agent Frameworkはその考え方を引き継ぎつつ、企業での本番運用を見据えた新しい基盤として位置付けられています。
すでにAutoGenで作ったシステムがある場合も、すぐに使えなくなるわけではありません。
ただ、新規に作るならMicrosoft Agent Frameworkを優先して検討するのが妥当です。
既存環境を移行する場合は、構成や依存関係の確認が必要になります。
Azureなど、Microsoftのクラウドや開発環境を中心に使っている企業にとっては、周辺サービスと組み合わせやすい点も選ぶ理由になります。
「AutoGenの名前で調べた情報が古くなっていないか」を確認してから採用を判断してください。
詳しくはMicrosoft Agent Framework 公式リポジトリをご覧ください。
OpenAI Agents SDK(ChatGPTのOpenAI公式)
OpenAI Agents SDKは、ChatGPTを提供するOpenAIが公開している、AIエージェントとマルチエージェントを作るための公式フレームワークです。
同社が実験的に公開していたSwarmを、本番利用に耐える形に発展させたものと位置付けられています。
基本の部品は少なく、指示とツールを持つ「エージェント」、ほかのエージェントに作業を任せる「ツールとしてのエージェント」と「ハンドオフ」、入力と出力を検証する「ガードレール」が中心です。
部品が少ないため、Pythonを書ける開発者なら短期間で使い方を覚えられます。
マルチエージェントの面では、受付役が担当に会話ごと引き継ぐハンドオフ型と、管理役がほかのエージェントを道具のように呼び出す型の両方を作れます。
処理の流れを可視化するトレース機能、人の確認を挟む仕組み、MCPで外部ツールを呼び出す機能も標準で備えています。
ChatGPTと同じモデルで業務用のマルチエージェントを作りたい場合の第一候補です。
インストールは「pip install openai-agents」で行えます。
トレースが最初から付いているため、デバッグのしにくさというマルチエージェントの弱点を抑えやすい点も選ぶ理由になります。
詳しくはOpenAI Agents SDK 公式ドキュメントをご覧ください。
GitHub Copilot(Copilot CLI・VS Code)
GitHub Copilotは、GitHubが提供するAIのコーディング支援サービスで、VS CodeとCopilot CLI(ターミナル版)の両方でサブエージェントに作業を任せる使い方ができます。
開発チームが普段のエディタのまま分業を試せるのが利点です。
VS Codeは2026年1月版(バージョン1.109)で、エディタを「マルチエージェント開発の拠点」と位置付けました。
Copilotのほかに、AnthropicのClaudeやOpenAIのCodexのエージェントも並べて動かせます。
サブエージェントはメインの会話と文脈を分けて独立して動き、最終結果だけがメインに返ります。
役割ごとのエージェントは、リポジトリの「.github/agents/」に「.agent.md」ファイルとして定義でき、計画役、レビュー役、テスト役のように担当を分けられます。
Copilot CLIには、作業を複数のサブエージェントに分けて並列に進める機能もあります。
開発チームがすでにGitHubとVS Codeを使っているなら、新しい基盤を作らずに試せる手軽さが魅力です。
コード以外の業務より、計画・実装・レビュー・テストといった開発工程の分担で効果を発揮します。
詳しくはGitHub Copilot 公式サイトをご覧ください。
Claude Code
Claude Codeは、Anthropicが提供するAIのコーディングエージェントで、役割ごとのサブエージェントを定義して作業を任せられます。ターミナルを中心に、開発作業を分業させたいエンジニアに向いています。
Claude Codeには、コードベースを読み取って調べる「Explore」、計画を立てる「Plan」、汎用の「general-purpose」といった組み込みのサブエージェントがあり、必要に応じて自動で使われます。
さらに、プロジェクトの「.claude/agents/」やユーザーの「~/.claude/agents/」にファイルを置くと、コードレビュー役やテスト役などの独自のサブエージェントを作れます。
サブエージェントはそれぞれ独立したコンテキストで動くため、調査で大量のファイルを読んでもメインの会話が散らかりません。
担当ごとに使えるツールを制限したり、軽い作業に高速なモデルを割り当ててコストを抑えたりもできます。
Claude Codeは、Siemensのレガシーコード刷新でも構成要素の1つとして使われています。
各サブエージェントの説明文が、Claude Codeが作業を任せるかどうかの判断材料になるため、担当範囲を具体的に書くことが使いこなしのポイントです。
「何を任せ、どのツールを触らせるか」をファイルで管理し、チームで共有できる点も選ぶ理由になります。
詳しくはClaude Code 公式ドキュメントをご覧ください。
Perplexity Teammates
Perplexity Teammatesは、Perplexityが2026年11月に公開した、継続的な業務を担うAIエージェントのサービスです。
目標を受け取ったエージェントがタスクに分解し、複数のエージェントで並列に実行し、仕事の量に応じてエージェントを追加するマルチエージェントの仕組みを備えています。
Teammatesは、同社の「Perplexity Computer」を土台にしており、各エージェントが専用のデスクトップ環境とブラウザを持って作業します。
一度きりの質問に答えるのではなく、指標の追跡やバグ報告の分類のように、継続して担当する仕事を任せることを想定しています。
開発フレームワークと違い、プログラミングなしでマルチエージェントを使える点が大きな違いです。
エンジニアがいない部署でも、分業するAIを業務で試せるのが利点で、調査やモニタリングのような情報系の業務と相性の良いサービスです。
提供開始時点では、Web版で最上位のMaxプランの契約者が対象です。
対象プランが限られるため、まず自社で任せたい継続業務を1つ決めてから試すと、費用に見合うかを判断しやすくなります。
詳しくはPerplexity公式サイトをご覧ください。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
AIマルチエージェントのやり方!簡単に始めるステップ
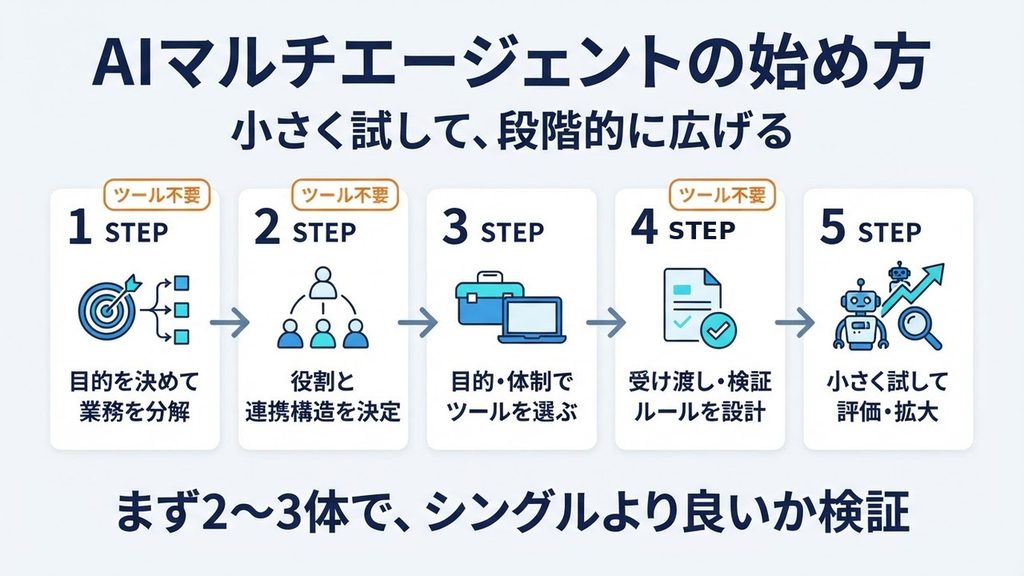
AIマルチエージェントを始めるには、目的を決めて業務を分解し、役割と連携構造を決め、ツールを選び、受け渡しと検証のルールを設計し、小さく試して段階的に増やす、の5ステップで進めます。
最初から多くのエージェントをつなぐのではなく、2〜3体の小さな構成で効果を確かめるのが失敗しにくい進め方です。
- 目的を決めて業務をサブタスクに分解する
- エージェントの役割と連携構造を決める
- 目的と開発体制に合わせてツールを選ぶ
- エージェント間の受け渡しルールと検証ポイントを設計する
- 小さく試して評価し、エージェントを段階的に増やす
ステップ1・2・4は紙やスプレッドシートでもでき、ツールを触る前に済ませられます。
ツール選びを先にすると、ツールの機能に合わせて業務をゆがめてしまいがちなため、この順番を守るのがポイントです。
最初の目標は「全部を自動化すること」ではなく「シングルエージェントより良いかを確かめること」に置いてください。
目的を決めて業務をサブタスクに分解する
最初のステップは、マルチエージェントで達成したい目的を1文で決め、業務をサブタスクに分解することです。
目的が曖昧なままでは、どこで分けるべきか、何をもって成功とするかが決まりません。
目的は「市場調査レポートの作成時間を半分にする」「問い合わせへの一次回答の正答率を上げる」のように、測れる形で書きます。
そのうえで、業務の開始から完了までを書き出し、工程ごとに分けます。
目的が複数ある場合は、最も効果を測りやすいものを1つ選び、ほかは後回しにします。
| 書き出す項目 | 例(市場調査レポート) |
| 開始の条件 | 調査テーマと対象企業のリストを受け取る |
| 工程 | 情報収集→数値の整理→比較分析→レポート執筆→出典確認 |
| 完了の条件 | 全社の比較表と出典付きのレポートがそろう |
| 最終承認者 | マーケティング部の担当者 |
分解したら、各サブタスクについて「ほかの作業を待たずに進められるか」を確認します。
独立して進められるサブタスクがほとんどない場合は、シングルエージェントのままの方が良いサインです。
目的・工程・完了条件・承認者の4つを書き出してから次に進むと、後のステップで迷いません。
エージェントの役割と連携構造を決める
2つ目のステップでは、分解したサブタスクをもとに、エージェントの役割と、どうつなぐかの連携構造を決めます。
役割は「工程」「情報源」「観点」のいずれかで分け、連携構造は階層型・逐次型・分散型から選びます。
最初は役割を2〜3つに絞るのが基本です。
例えば市場調査なら、情報収集役、レポート作成役、出典確認役の3つから始めます。
役割を細かく分けすぎると、やり取りが増えてコストと管理の手間がかさみます。
迷ったときは、Anthropicのリサーチ機能のように「統括役+並列の担当+確認役」の階層型から始めると、後で担当を足し引きしやすくなります。
連携構造は、次の目安で選びます。
- 並列に進めたい作業がある → 階層型(統括役が割り振る)
- 手順が決まっていて順番に進めればよい → 逐次型
- 依頼の内容によって担当が変わる → 分散型(ハンドオフ)
役割ごとに、担当範囲、使えるツール、触ってはいけないものを1行ずつ書いておくと、ステップ4の受け渡しルールを作るときにそのまま使えます。
役割と構造は、後で入れ替えられる前提で軽く決めるくらいで構いません。
目的と開発体制に合わせてツールを選ぶ
3つ目のステップでは、目的と開発体制に合わせてツールを選びます。
判断の軸は、エンジニアが社内にいるか、どのモデルを使いたいか、既存システムとどこまでつなぐか、の3つです。
| 状況 | 選択肢 | 理由 |
| エンジニアがいない、まず体験したい | Perplexity Teammates | プログラミングなしで分業するAIを試せる |
| 開発作業を分担させたい | GitHub Copilot、Claude Code | 普段の開発環境でサブエージェントを使える |
| 役割分担型の業務システムを作りたい | CrewAI | 役割とタスクで構成を素早く書ける |
| 分岐や承認を細かく制御したい | LangGraph | 状態と流れを明示して設計できる |
| ChatGPTと同じモデルで作りたい | OpenAI Agents SDK | ハンドオフとトレースを標準で備える |
| Microsoft環境で本番運用したい | Microsoft Agent Framework | AutoGenの後継として案内されている |
エンジニアがいない場合は、まずサービス型のツールで「分業するAIが自社の業務で役に立つか」を確かめるのが現実的です。
効果が見えた段階で、社内システムとの接続が必要になればフレームワークでの開発に進みます。
エンジニアがいる場合も、いきなり本番向けに作り込むより、CrewAIやOpenAI Agents SDKのような部品の少ないフレームワークで試作し、要件が固まってからLangGraphなどで作り直す進め方があります。
試作の段階で、必要な機能(分岐、承認、ログ)が見えてくるためです。
ツール選びで見落としやすいのが、既存システムとの接続です。社内のデータベースや業務アプリとつなぐなら、MCPに対応したツールを選ぶと接続の手間を減らせます。
他社のエージェントと連携する予定があれば、A2Aへの対応も確認しておきます。
ツールの機能や料金、提供条件は短い期間で変わるため、選ぶ時点で公式サイトの最新情報を確認してください。
「今の体制で試せるか」と「効果が出たときに広げられるか」の2つを満たすツールを選ぶと、乗り換えの手間を抑えられます。
ツールは体制と目的から選べば、乗り換えの手間を減らせます。
自社の体制に合うツールと試す範囲を整理したい場合は、下記から相談できます。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
エージェント間の受け渡しルールと検証ポイントを設計する
4つ目のステップでは、エージェント間で何をどの形式で渡すかという受け渡しルールと、どこで結果を確かめるかという検証ポイントを設計します。
ここを決めずに動かすと、誤りの連鎖や原因の分からない不具合が起きやすくなります。
受け渡しルールでは、渡す項目と形式を決めます。
形式はJSONのような決まった型で指定しておくと、エージェントが項目を書き漏らしたときに機械的に検出できます。
| 項目 | 内容の例 |
| 目的 | このサブタスクで何を明らかにするか |
| 結論 | 担当が出した答え |
| 根拠 | 出典のURLと取得日、使ったデータ |
| 未解決の点 | 分からなかったこと、判断を保留したこと |
| 次への依頼 | 次の担当に確認してほしいこと |
検証ポイントは、誤りが後ろに広がると影響が大きい場所に置きます。
数値を受け取った直後、最終成果物をまとめる前、外部に送信する前が代表的です。
それぞれ、AIの確認役が見るのか、人が見るのかも決めます。
あわせて、エージェントごとの最大の呼び出し回数、タイムアウト、やり取りの往復の上限も決めておきます。
終わり方を決めていないマルチエージェントは、コストと時間を使い続けるおそれがあるためです。
小さく試して評価し、エージェントを段階的に増やす
5つ目のステップでは、対象を絞った小さな構成で試し、シングルエージェントと比べて評価してから、エージェントを段階的に増やします。
最初から大きな構成で始めると、問題が起きたときにどこが原因か分からなくなります。
評価には、実際の業務に近い質問や依頼を20件ほど用意します。
Anthropicも、マルチエージェントの開発初期には実際の利用に近い約20件の質問で評価を始め、変更の効果をはっきり確認できたとしています。
同社によると、初期は改善の余地が大きく、プロンプトの調整1つで成功率が30%から80%に上がるほどの変化が起こりうるため、少ない件数でも差が見えます。
比べる項目は次の4つです。
- 品質:正しい答えや期待した成果物が出たか
- 処理時間:1件あたりにかかった時間
- コスト:1件あたりの利用料
- 人の手間:確認や修正にかかった時間
シングルエージェントより明らかに良くなった場合にだけ、次の役割を1つ追加します。
変更は1回に1つに絞り、同じ評価用の質問で比べると、何が効いたのかを追えます。
効果が数字で確認できた分だけ増やすことが、マルチエージェントを無駄なく育てる方法です。
まとめ:マルチエージェントシステムとシングルエージェントAIは使い分けるやり方がベスト
マルチエージェントシステムとシングルエージェントAIは、どちらが優れているかではなく、業務に合わせて使い分けるのが最善のやり方です。
マルチエージェントは、複数のAIエージェントが役割を分担し、結果を受け渡しながら1つの目的を達成する仕組みで、独立して分けられる作業が多く、検証の価値が高く、1体では扱いきれない情報量の業務で力を発揮します。
一方で、Anthropicの公開データではトークン消費がチャットの約15倍になり、誤りの連鎖やデバッグのしにくさ、権限管理の複雑さといった課題もあります。
短い問い合わせや手順の決まった処理なら、シングルエージェントの方が速く安く済みます。
| 業務の特徴 | 向いている構成 |
| 調べる方向が多い調査、工程の多い開発、膨大な資料の扱い | マルチエージェント |
| 定型の問い合わせ、短い要約、即答が必要な処理 | シングルエージェント |
始めるときは、まずシングルエージェントで試し、限界が見えた工程だけを2〜3体の小さな構成で分業するのが近道です。
目的と工程を分解し、役割と連携構造を決め、体制に合うツールを選び、受け渡しと検証のルールを設計してから、数字で効果を確かめながら増やしていきます。
マルチエージェントの成否を決めるのは、AIの数ではなく分業と受け渡しの設計です。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)


人気記事
-
2026年11月15日(日)
マルチエージェントシステムとは?【やり方やAIの仕組み】実用例まで紹介
-
2026年11月10日(火)
【2026年11月最新】Google Cloud & Google AIアップデートまとめ|Gemini Omni 1.2 Flash・Claude Fable 5.2ほか新機能と注意点
-
2026年11月9日(月)
Agentic AIとは?生成AIとエージェント型の違い!活用事例や使い方まで解説
-
2026年11月4日(水)
AI駆動開発とは?わかりやすく解説|開発フロー・やり方・ツール・活用事例まで
-
2026年10月30日(金)
MCPサーバーとは?【仕組み・料金】作り方やおすすめServerも紹介