vLLMとは?仕組みや利用方法【Ollamaとの違い】導入事例も紹介
技術ブログ
vLLM(ブイエルエルエム)は、LlamaやQwenなどの大規模言語モデル(LLM)を、高速かつ少ないGPUメモリで動かすためのオープンソースの推論エンジンです。
社内向けAIチャットやRAGの本番基盤として採用が広がる一方で、「Ollamaと何が違うのか」「Windowsでも動くのか」と迷う人も少なくありません。
本記事では、vLLMの仕組みや特徴、環境別の導入方法、業界別の導入事例、導入を相談できる企業までをまとめて解説します。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
vLLMとは何か?【LLMを動かす推論エンジン】
vLLMは、学習済みのLLMを効率よく動かし、ユーザーからのリクエストに応答を返すための「推論・サービングエンジン」です。
2023年にカリフォルニア大学バークレー校のSky Computing Labで開発され、PagedAttentionという独自のメモリ管理技術を発表した論文とともに公開されました。
名前の「v」はvirtual(仮想)に由来し、OSの仮想メモリの考え方から着想を得ています。
2024年7月にはLinux Foundationに寄贈され、現在は2,000人を超える貢献者が開発に参加するコミュニティ主導のプロジェクトです。
ライセンスはApache 2.0で、商用利用も含めて無料で使えます。
vLLMの目的は、1秒あたりに処理できるトークン数(スループット)を最大化し、多くのユーザーに同時に応答することです。
そのため、個人のPCで手軽にチャットするよりも、社内システムやWebサービスの裏側でLLMを動かす本番用途で真価を発揮します。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
vLLMとLLMの違いとは
LLMは文章を理解・生成する「モデル」そのもので、vLLMはそのモデルを動かす「エンジン」です。
名前が似ているため混同されがちですが、役割はまったく異なります。
料理にたとえると、LLMは「レシピ」、vLLMはそのレシピを使って大量の注文を素早くさばく「厨房の仕組み」のようなものです。
Llama、Qwen、Gemma、DeepSeekといったLLMは、単体ではファイルとして存在するだけで、誰かの質問に答えることはできません。
モデルをGPUに読み込み、届いたリクエストを処理して回答を返す仕組みが必要で、その役割を担うのがvLLMです。
つまり、vLLMを使ってもLLMの賢さそのものは変わりません。
変わるのは、同じモデルをどれだけ速く、どれだけ多くの人に、どれだけ少ないGPUで提供できるかという「運用効率」です。
モデル選びとエンジン選びは別の判断だと押さえておきましょう。
vLLMの特徴とメリット
vLLMの最大の特徴は、同じGPUでより多くのリクエストを、より速く処理できることです。
その結果、応答速度の向上とGPUコストの削減を同時に実現できます。
加えて、既存アプリとの連携のしやすさや、対応ハードウェア・モデルの幅広さも、多くの企業に選ばれる理由です。
ここでは、vLLMの主な特徴と、それによって得られるメリットを5つ紹介します。
同時アクセスが多くても応答速度を保てる高スループット
vLLMは、多数のリクエストが同時に届いても応答速度が落ちにくい設計になっています。
公式の発表では、Hugging Face Transformersで同じモデルを動かした場合と比べて最大24倍のスループットを記録しています。
これを支えているのが「連続バッチ処理(Continuous Batching)」です。
従来の方式では、複数のリクエストをまとめて処理する際、全員の回答が書き終わるまで次のリクエストを受け付けられませんでした。
vLLMは、回答を書き終えたリクエストからすぐに枠を空け、待っているリクエストを随時差し込みます。
GPUが遊ぶ時間がほとんどなくなるため、社内の多くの社員が同時にAIチャットを使う場面や、Webサービスでアクセスが集中する場面でも、待ち時間を抑えられます。
同じ台数のGPUで処理できる量が増えるので、サーバーの追加購入やクラウドの利用料を抑えられる点も大きなメリットです。
OpenAI互換APIで既存アプリから接続先を切り替えるだけで使える
vLLMには、OpenAIのAPIと同じ形式で呼び出せるAPIサーバーが標準で組み込まれています。
「vllm serve」コマンドでモデルを指定して起動するだけで、チャット補完などのエンドポイントがすぐに使えるようになります。
そのため、ChatGPTのAPIを使って開発したアプリであれば、プログラムの書き換えはほとんど必要ありません。
OpenAIの公式SDKの接続先(base_url)を自社のvLLMサーバーに向けるだけで、外部APIから自前のLLMへ切り替えられます。
LangChainやLlamaIndex、Difyなど、OpenAI互換APIに対応した開発ツールとも組み合わせやすくなっています。
ストリーミング出力、JSON形式などの構造化出力、外部ツールを呼び出すツール呼び出し(Function Calling)にも対応しています。
社外にデータを出せない業務でも、開発体験を変えずにAIを組み込めるのが大きな利点です。
NVIDIA以外のGPUやTPU、主要なオープンモデルまで幅広く対応している
vLLMは、特定のハードウェアやモデルに縛られにくい点も特徴です。
主力はNVIDIA製GPUですが、AMD製GPU、IntelのGPUとCPU、Google TPU、Intel Gaudi、AWS Trainiumなどにも対応しています。
Apple SiliconのMacも、プラグインを通じて利用できるようになりました。
モデルについては、Hugging Face上の200を超えるモデルアーキテクチャに対応しています。
Llama、Qwen、Gemma、DeepSeek、Mistral、gpt-ossといった主要なオープンモデルは、公開直後から使えるケースがほとんどです。
さらに、FP8、INT4、GPTQ、AWQなどの量子化にも対応しています。
量子化とはモデルを軽量化する技術で、精度の低下を抑えながら必要なGPUメモリを大きく減らせます。
手持ちのGPUの性能に合わせてモデルの大きさを調整できるため、導入時のハードウェア選択の自由度が高くなります。
GPUメモリの無駄をほぼゼロにして多くのリクエストを同時に載せられる(PagedAttention)
vLLMの代名詞ともいえる技術がPagedAttentionです。
OSが使う仮想メモリ管理(ページング)の仕組みを、LLMの「KVキャッシュ」に応用しています。
KVキャッシュとは、LLMが会話の文脈を覚えておくための短期記憶のようなデータです。
回答が長くなるほど大きくなりますが、最終的にどこまで伸びるかは事前にわかりません。
そのため従来の方式では、リクエストごとに最大の長さを想定したGPUメモリをまとめて確保していました。
実際には使われない領域が大量に生まれ、vLLMの論文では、既存のシステムがKVキャッシュ用メモリの60〜80%を無駄にしていたと指摘されています。
PagedAttentionは、KVキャッシュを小さなブロックに分け、必要になった分だけ空いている場所に割り当てます。
メモリの断片化が解消され、無駄は4%未満まで減りました。
空いたメモリに別のリクエストを載せられるため、同時に処理できる数が大きく増えます。
プレフィックスキャッシュや投機的デコーディングなどの最適化機能で推論をさらに速められる
vLLMには、PagedAttention以外にも推論を速くするための最適化機能が数多く備わっています。
代表的なのが次の4つです。
- プレフィックスキャッシュ:システムプロンプトなど、複数のリクエストで共通する冒頭部分の計算結果を再利用し、同じ計算の繰り返しを省きます。
- チャンクドプリフィル:長い入力文を小さな単位に分けて処理し、ほかのリクエストの回答生成を止めずに済むようにします。
- 投機的デコーディング(Speculative Decoding):小さなモデルなどで先に候補を予測し、本命のモデルでまとめて確認することで、生成を速めます。
- マルチLoRA:1つのベースモデルに、用途別に追加学習した複数のLoRAを同時に載せて切り替えられます。
これらは起動時のオプションで有効にできるものが多く、用途に合わせて組み合わせることで、同じGPUのままさらに性能を引き出せます。
vLLMが高速に動く仕組み【PagedAttentionと連続バッチ処理】
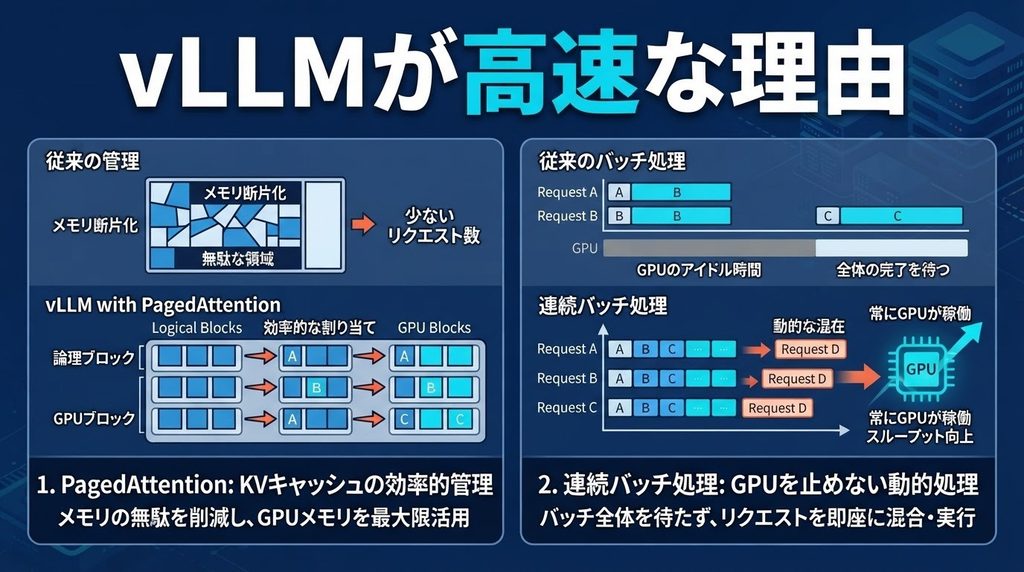
vLLMが速い理由は、「メモリの使い方」と「処理の順番」の両方を最適化している点にあります。
LLMの推論には、従来から2つのボトルネックがありました。
1つ目はメモリです。LLMは回答を1語ずつ生成するたびにKVキャッシュを書き足していくため、リクエストが増えるほどGPUメモリが足りなくなります。
2つ目は待ち時間です。回答の長さはリクエストごとにばらばらなのに、まとめて処理すると一番長い回答が終わるまで全員が待たされていました。
vLLMは、この2つを次のように解消しています。
- PagedAttentionでメモリを細かく割り当てる:KVキャッシュを小さなブロック単位で管理し、空き領域を無駄なく使います。同じGPUに載せられるリクエストの数が増えます。
- 連続バッチ処理で処理の枠を埋め続ける:回答を終えたリクエストからすぐに枠を空け、次のリクエストを差し込みます。GPUが止まる時間がなくなります。
メモリに余裕が生まれるから多くのリクエストを同時に扱え、枠を埋め続けるからGPUが常にフル稼働する。
この2つがかみ合うことで、高いスループットが生まれています。
vLLMでできること
vLLMを使うと、外部のAIサービスに頼らず、自社のGPU上でLLMを使ったサービスを本番運用できます。
特に、機密情報を社外に出せない業務や、利用者が多くAPI料金が膨らみやすい業務で効果を発揮します。
ここでは、企業での代表的な使い方を3つ紹介します。
社内専用のチャットAIを自前のGPUで提供する
もっとも多い使い方が、ChatGPTのようなチャットAIを社内専用に用意するケースです。
vLLMでLlamaやQwenなどのモデルを起動し、Open WebUIなどのチャット画面をつなげば、社員がブラウザから使えるAIアシスタントが完成します。
入力した内容はすべて社内のサーバーで処理されるため、顧客情報や開発中の製品情報を扱う部署でも安心して使えます。
外部のAPIを使う場合と違い、利用者が増えても1回ごとの料金はかかりません。
vLLMは同時アクセスに強いため、数十人から数百人規模の社員が同じ時間帯に使っても応答速度を保ちやすいのが特長です。
部署ごとに用途別のLoRAを切り替えて、法務向けや営業向けといった専用アシスタントを1台のGPUで提供することもできます。
社内文書を参照して回答するRAGシステムの推論基盤にする
RAG(検索拡張生成)は、社内マニュアルや規程、過去の問い合わせ履歴などを検索し、その内容をもとにLLMに回答させる仕組みです。
LLMが知らない社内の情報にも答えられるため、問い合わせ対応やナレッジ検索の効率化に広く使われています。
vLLMは、このRAGで回答文を生成する部分を担います。
RAGでは検索した文書をまとめてプロンプトに入れるため、1回あたりの入力が長くなりがちです。
vLLMはチャンクドプリフィルで長い入力を効率よく処理でき、プレフィックスキャッシュで共通の指示文の計算も省けます。
OpenAI互換APIを備えているため、LangChainやLlamaIndex、Difyといった定番のRAG開発ツールとそのまま接続できます。
検索部分と生成部分を分けて設計しやすい点も、vLLMが選ばれる理由です。
大量のテキストを一括で要約・分類するバッチ推論を回す
vLLMは、チャットのように1件ずつ応答するだけでなく、大量のデータをまとめて処理する「バッチ推論」も得意です。
Pythonのプログラムから直接vLLMを呼び出し、数万件の文書を一度に投入できます。
たとえば、コールセンターの通話記録の要約、アンケートの自由回答の分類、商品レビューの感情分析、契約書からの項目抽出などに使えます。
人手では何日もかかる作業を、GPUを使って短時間で終わらせられます。
外部APIでこうした大量処理を行うと、件数に比例して料金が増え、利用上限に引っかかることもあります。
自前のvLLMであれば、GPUの稼働時間だけでコストが決まるため、処理件数が多いほど費用面のメリットが大きくなります。
夜間にまとめて処理するなど、GPUの空き時間を有効に使えるのも利点です。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
vLLMと他のローカルLLMツールの比較
ローカルでLLMを動かすツールはvLLM以外にもあり、得意分野がはっきり分かれています。
大まかには、vLLMは「多人数向けの本番サーバー」、Ollama・llama.cpp・LM Studioは「1人で手軽に動かす個人・検証用」と考えるとわかりやすいでしょう。
まずは全体像を表で確認し、そのあと1つずつ違いを解説します。
| ツール | 主な用途 | 同時アクセスへの強さ | 対応OS | 主なモデル形式 | 導入の手軽さ |
|---|---|---|---|---|---|
| vLLM | 本番サーバー、多人数での利用 | 非常に強い | Linux中心(WindowsはWSL2、Macはプラグイン) | Safetensors(Hugging Face形式) | Python環境の知識が必要 |
| Ollama | 個人利用、開発中の試用 | 弱い | Windows・Mac・Linux | GGUF | コマンド1つで始められる |
| llama.cpp | 少ないVRAMやCPUでの高速実行 | 弱い | Windows・Mac・Linux | GGUF | ビルドや設定にやや知識が必要 |
| LM Studio | 非エンジニアの検証、PoC | 弱い | Windows・Mac・Linux | GGUF、MLX | 画面操作だけで使える |
vLLMとOllamaの違い
両者の最大の違いは、想定している利用人数です。
Ollamaは1人のユーザーが自分のPCで手軽にLLMを動かすためのツールで、vLLMは多くのユーザーからの同時アクセスをさばくためのエンジンです。
Ollamaは、コマンド1つでモデルのダウンロードから起動までを済ませられる手軽さが魅力です。
4bitなどに量子化されたGGUF形式のモデルを使うため、GPUのないPCやMacでも動きます。
一方で、初期設定では同時に処理するリクエスト数が少なく抑えられており、多人数で使うと待ち時間が増えます。
vLLMは導入の手間がかかるものの、PagedAttentionと連続バッチ処理によって同時アクセス時の処理量で大きく上回ります。
どちらもOpenAI互換APIを備えているため、「開発中はOllama、本番環境はvLLM」と使い分け、同じアプリのコードを接続先だけ切り替えて使う企業も少なくありません。
vLLMとllama.cppの違い
llama.cppは、C/C++で書かれた軽量な推論エンジンです。
少ないGPUメモリやCPUだけの環境でもLLMを動かせるよう最適化されており、OllamaやLM Studioの内部でも使われています。
得意分野は「1人で使うときの速さと軽さ」です。GGUF形式による量子化でモデルを小さくできるため、ゲーミングPCやMacBookでも大きめのモデルを扱えます。
1件ずつのリクエストであれば、最初の1語が返ってくるまでの時間も短く、使用するメモリも少なく済みます。
一方、vLLMは「多人数で使うときの総処理量」に強みがあります。
同時に数十件のリクエストが届くような環境では、連続バッチ処理を持つvLLMのほうが全体として何倍もの量をさばけます。
個人のワークステーションや組み込み用途ならllama.cpp、チームやサービス向けのサーバーならvLLMと考えるとよいでしょう。
vLLMとLM Studioの違い
LM Studioは、画面操作だけでLLMを探してダウンロードし、チャットまでできるデスクトップアプリです。
コマンド操作が不要なため、エンジニア以外の担当者でもローカルLLMを試せます。
内部ではllama.cppやApple向けのMLXを使っており、Windows・Mac・Linuxで動作します。
ローカルサーバー機能でOpenAI互換APIも提供できますが、基本的には1台のPCで1人が使うことを前提としたツールです。
vLLMは画面を持たないサーバー向けのエンジンで、Linuxのコマンド操作やPythonの知識が前提になります。
その代わり、多人数での利用や長時間の安定運用、複数GPUでの大規模モデルの実行に対応できます。
「どのモデルが自社の業務に合うか」をLM Studioで手軽に見極め、本番運用はvLLMで行うという進め方も効率的です。
vLLMの利用が向いている人
vLLMが向いているのは、「複数の人やシステムが同時に使うLLMを、自社の環境で安定して動かしたい人」です。
具体的には、次のいずれかに当てはまる場合は導入を検討する価値があります。
- 社内の多くの社員や、自社サービスのユーザーが同時にLLMを使う予定がある
- 顧客情報や機密情報を扱うため、外部のAIサービスにデータを送れない
- OpenAIなどのAPI料金が利用者の増加とともに膨らんでおり、コストを抑えたい
- NVIDIA製のGPUサーバーや、クラウドのGPUインスタンスを用意できる
- Linuxのサーバー運用やPythonの環境構築に慣れたエンジニアが社内にいる
特に、Ollamaなどで検証を済ませ、「次は本番環境で多くの人に使ってもらいたい」という段階にある企業にとって、vLLMはもっとも有力な選択肢です。
社内にエンジニアがいない場合でも、後述する導入支援企業に依頼すれば活用できます。
vLLMの利用が向いていない人
一方で、目的によってはvLLMを選ぶとかえって遠回りになります。
次のような場合は、OllamaやLM Studioなど、より手軽なツールから始めるほうが適しています。
- 自分1人で、PCでLLMとチャットしたり試したりしたいだけ
- GPUを搭載していないノートPCで動かしたい
- コマンド操作やPythonの環境構築に慣れていない
- まずはどのモデルが業務に使えるかを手早く比べたい
vLLMは、多くのリクエストを同時に処理してこそ強みが生きるエンジンです。
1人で使う場面では、手軽なツールとの速度差はほとんど感じられません。
また、起動時にGPUメモリの大部分を先に確保する仕組みのため、同じPCでほかのGPUを使うアプリを動かしにくい点にも注意が必要です。
まずは手軽なツールでLLMの使い勝手を確かめ、多人数での利用が見えてきた段階でvLLMに移行するのが、失敗の少ない進め方です。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
業界・用途別の導入事例
vLLMは、通信、金融、ソフトウェア開発、接客など、幅広い業界ですでに使われています。
共通しているのは、「データを社外に出さずに、多くの人が同時に使えるLLM環境をつくる」という目的です。
ここでは、公開されている情報をもとに、業界ごとの具体的な使い方を4つ紹介します。
【通信・IT】IIJは社内向けローカルLLM APIサーバの推論エンジンにvLLMを採用
インターネットイニシアティブ(IIJ)は、社内ネットワークの中にローカルLLMのAPIサーバを構築し、社員が安全にLLMを使える環境を整えました。
構成の中心はvLLMのサーバ群です。
複数のvLLMサーバを立て、それぞれに異なるLLMを読み込ませています。
その前段にFastAPIで作った窓口を置き、リクエストで指定されたモデル名に応じて、vLLMサーバか、軽量なllama.cppサーバに振り分ける仕組みです。
利用者は1つの接続先を使うだけで、複数のモデルを使い分けられます。
モデルには、GoogleのGemma 2を日本語向けにチューニングしたモデルなどを採用しています。
同社は、vLLMの採用によってストレスのない応答速度を実現できたことを成果に挙げています。
用途に応じて複数のモデルを社内APIとして提供したい企業にとって、参考になる構成です。
【金融】規程・法令を検索する社内RAGをvLLMで完全オンプレ構築(Aurant支援事例)
従業員300名規模の金融機関では、社内規程や法令を検索して回答するRAGシステムを、vLLMを使って構築しました。
導入を支援したのは、ローカルLLMの構築支援を手がけるAurant Technologiesです。
金融業界では、顧客情報や社内の判断基準を外部のAIサービスに送ることに高いハードルがあります。
そこでこの事例では、データを一切社外に送らない完全オンプレミスの構成を採用しました。
推論にはvLLMを使い、Llama 3.1 70Bを4bitに量子化して動かしています。
GPUはNVIDIA L40Sを2枚使い、同時に10人までが利用できる構成です。
70Bクラスの大きなモデルでも、量子化とvLLMの効率的なメモリ管理によって、比較的少ないGPUで実用的に運用できることを示す事例といえます。
【ソフトウェア開発】ThoughtworksはIDEのコーディング支援とチャットボットの基盤にvLLMを活用
グローバルなITコンサルティング企業のThoughtworksは、技術動向をまとめた「Technology Radar」で、自社チームによるvLLMの活用経験を紹介しています。
同社のチームは、ローカルの仮想マシン上でDockerを使ってvLLMを動かし、OpenAI互換のAPIサーバとして提供しました。
このAPIを、IDEに組み込んだコーディング支援プラグインやチャットボットなど、複数のアプリケーションから利用しています。
動かしたモデルは、コード生成向けのCodeLlama 70B・7Bや、Mixtralなどです。
同社は、設定を少し変えるだけで7Bから70Bのモデルに切り替えられる拡張性の高さも評価しています。
チームからの反応も良好で、LLMを本番環境に投入したい場合にvLLMは検討に値すると結論づけています。
開発チーム向けのAIコーディング基盤を自前で持ちたい企業の参考になる事例です。
【接客・デジタルヒューマン】デジタルヒューマン社はオンプレ対話AIのLLM実行環境にvLLMを組み込む
デジタルヒューマン株式会社は、人のような見た目で会話するデジタルヒューマンを、オンプレミスで動かせる環境「MiniPrem(ミニプレム)」を提供しています。
その対話機能を支えるLLMの実行環境として、vLLMを組み込んでいます。
フルインストール構成を選ぶと、vLLMがMistral-7B-Instructを動かし、OpenAI互換のAPIをサーバー内で提供します。
外部のLLM APIではなく、社内のサーバーで動くLLMと対話させたい場合に有効にする仕組みです。
来店客や利用者との会話内容を外に出さずに済むため、接客や受付の用途でもデータ管理の不安を減らせます。
なお、2026年6月時点でvLLMを含むフルインストールの構成要素は同社の正式サポート対象外とされています。
採用を検討する場合は、サポート範囲を事前に確認しておきましょう。
【環境別・モデル別】vLLMの導入方法
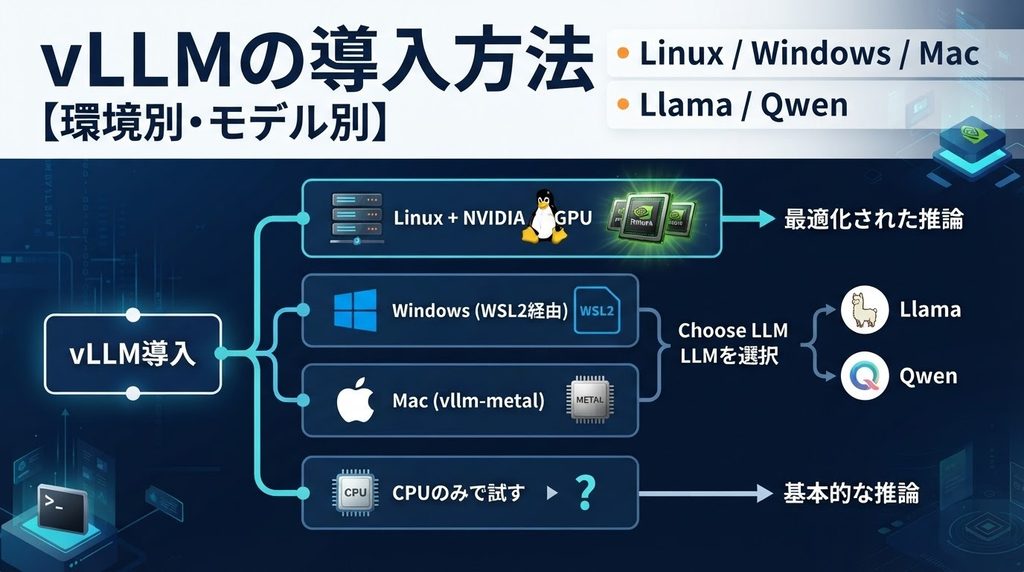
vLLMの標準的な動作環境は、LinuxとNVIDIA製GPUの組み合わせです。
WindowsやMac、GPUのないPCでも、方法を選べば動かせます。
モデルは、GPUのメモリ(VRAM)に収まる大きさから選ぶのが基本です。
目安として、8B程度のモデルを標準の精度で動かすなら24GB前後、70Bクラスのモデルを4bit量子化で動かすなら48GB以上のVRAMを確保すると安心です。
まずは0.5B〜8B程度の小さなモデルで動作を確認してから、本番用のモデルに切り替えましょう。
Ubuntu・LinuxではpipやuvでPython環境にインストールする
UbuntuなどのLinuxにNVIDIA製GPUを搭載した環境が、vLLMをもっとも素直に使える構成です。
事前に、NVIDIAのドライバーとPython 3.10以上を用意しておきます。
インストールは、Pythonの仮想環境を作ったうえでpipか、より高速なuvを使います。
uv venv --python 3.12 && source .venv/bin/activate
uv pip install vllm
インストールできたら、Hugging Faceのモデル名を指定してサーバーを起動します。
モデルは初回起動時に自動でダウンロードされます。
vllm serve Qwen/Qwen3-0.6B標準ではポート8000でOpenAI互換のAPIが立ち上がります。
別のターミナルから「curl http://localhost:8000/v1/models」を実行し、モデル名が返ってくれば準備完了です。
LlamaやGemmaなど、利用規約への同意が必要なモデルを使う場合は、Hugging Faceのアクセストークンを環境変数に設定しておきましょう。
Dockerでは公式イメージ(vllm/vllm-openai)で起動する
Pythonの環境構築を避けたい場合や、本番サーバーで同じ環境を再現したい場合は、Dockerを使う方法がおすすめです。
vLLMの公式イメージ「vllm/vllm-openai」には、vLLM本体と必要なライブラリがすべて含まれています。
GPUをコンテナから使うため、事前にNVIDIA Container Toolkitをインストールしておきます。
そのうえで、次のように起動します。
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:latest --model Qwen/Qwen3-0.6B
モデルの保存先をボリュームとしてマウントしておくと、コンテナを作り直しても再ダウンロードが不要になります。
本番環境では「latest」ではなくバージョンを固定したタグを使うと、意図しない更新による不具合を防げます。
複数のサーバーで同じ構成を展開しやすく、Kubernetesでの運用にもそのまま移行できます。
WindowsではWSL2を経由して動かす
vLLMは公式にはLinuxを前提としたソフトウェアのため、Windowsにそのままインストールすることはできません。
Windowsで動かす場合は、WSL2(Windows Subsystem for Linux 2)でUbuntuなどのLinux環境を用意し、その上にvLLMを導入するのが基本です。
NVIDIA製GPUを使う場合は、Windows側に最新のNVIDIAドライバーを入れておけば、WSL2内からCUDAを利用できます。
WSL2上でPython環境を整え、pipでvLLMをインストールする流れはUbuntuとほぼ同じです。
より手軽に試したい場合は、Docker DesktopのWSL2バックエンドを使う方法もあります。
vLLM公式のDockerイメージを使えば、PythonやCUDAまわりの依存関係を自分で揃える必要がありません。
さらにDocker Desktop 4.54以降では、Docker Model RunnerのvLLMバックエンドも利用できます。
環境構築でつまずきたくない人は、Docker経由から始めるのがおすすめです。
MacではApple Silicon向けのvllm-metalで動かす
MacではNVIDIA GPU向けのCUDAが使えないため、Apple SiliconのMetal GPUに対応したプラグイン「vllm-metal」を使います。
vllm-metalはもともとDockerのエンジニアが開発したもので、現在はvLLMプロジェクトのGitHub組織に移管されたオープンソースです。
対象はM1〜M4などMシリーズチップ搭載のMacです。
注意したいのは、Hugging Face上のすべてのモデルがそのまま動くわけではない点です。
vllm-metalが扱うのはMLX形式(Appleの機械学習フレームワーク向けの形式)のモデルで、NVIDIA GPU向けの量子化モデルなどは基本的に対象外です。
Hugging Faceのmlx-communityで公開されている、Mac向けに変換済みのモデルを選ぶのが近道です。
導入は、Docker Desktop 4.62以降でvllm-metalバックエンドを追加する方法が手軽です。
OpenAI互換APIもLinux版と同じように使えます。
GPUがないPCではCPU版のvLLMで動かす
最初に押さえておきたいのは、CPU版のvLLMは「動く」ものの、推論速度はGPUに比べて大幅に落ちるという点です。
vLLMの強みである高スループットは、GPUの並列計算があって初めて発揮されます。
そのためCPU版は、動作確認や検証、小さなモデルでの試用向けと割り切るのが現実的です。
本番運用や複数人での利用を想定しているなら、GPU環境やクラウドGPUを検討しましょう。
CPU版を動かすには、Linux環境(WindowsならWSL2)とPython 3.10以上が必要です。
CPUの命令セットにも条件があり、x86_64ならAVX2以上(AVX-512があればより高速)、ARM系ならNEON対応が求められます。
古いCPUでは動かない場合があるため、事前に確認しておくと安心です。
インストールは公式ドキュメントのCPU向け手順に従います。
モデルは0.5B〜1B程度の小型モデルから試すと、待ち時間が少なく挙動を確かめやすくなります。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)
vLLMの導入・開発支援を依頼できるおすすめ企業4選
vLLMは無料で使えるものの、GPUサーバーの選定から環境構築、セキュリティ設計、運用までを社内だけで進めるのは簡単ではありません。
社内にエンジニアが不足している場合は、ローカルLLMの構築実績を持つ企業に相談するのが近道です。
ここでは、GPU基盤からRAGの構築まで、得意分野の異なる4社を紹介します。
依頼の際は、vLLMでの構築実績や対応範囲を事前に確認しておきましょう。
株式会社センティリオンシステム
センティリオンシステムは、Google Cloudを中心としたクラウドインテグレーションを手がける、Google Cloud認定パートナー企業です。
クラウドインフラの設計からアプリケーション開発、運用保守までをワンストップで提供しています。
大阪事業所にはクラウドに特化したエンジニア組織があり、在籍エンジニアのほぼ全員がGoogle Cloudの認定資格を持っています。
AI・機械学習の専門人材も在籍しており、クラウド上でのAI活用支援に力を入れています。
自社でGPUサーバーを購入するのではなく、Google CloudのGPU環境上にvLLMの推論基盤を構築したい企業に向いています。
クラウドであれば、検証段階は小さなGPUで始め、利用者の増加に合わせて規模を広げられます。
オンプレミスよりも初期投資を抑えて、LLMの本番運用を始めたい場合の相談先として検討するとよいでしょう。
NTTPCコミュニケーションズ(GPUソリューション)
NTTPCコミュニケーションズは、NTTグループでGPUを使ったAI基盤の設計・構築を手がける企業です。
NVIDIAのパートナー認定制度では、最上位レベルの「エリートパートナー」に認定されています。
NTTの研究所が開発した国産LLM「tsuzumi」のGPUプラットフォームをはじめ、大規模なGPUクラスターの構築経験を持つ点が強みです。
自社でデータセンターとネットワークサービスを運営しており、GPUサーバー本体だけでなく、ネットワークやセキュリティ、設置場所まで含めて一括で相談できます。
同社のコラムでは、vLLMなどの推論エンジンを使ったローカルLLM環境を、検証・部門・全社という段階ごとにどう設計するかも解説しています。
数十人から全社規模で使う本格的なGPU基盤を、オンプレミスで整えたい企業に向いています。
NTTPCコミュニケーションズ(GPUソリューション)についてはこちら
インテック(ローカルLLM導入支援)
https://www2.tisi.jp/news/2026/0129_1.html
インテックは、TISインテックグループのシステムインテグレーターです。
2026年1月29日から、オンプレミス環境で生成AIを使える「ローカルLLM導入支援」を提供しています。
このサービスでは、クラウドを介さずに動くLLM環境を最短1カ月で構築します。
主な対象は、セキュリティやコストへの不安から生成AIの導入に踏み切れずにいる製造業や金融業などの企業です。
外部と遮断された社内ネットワークの中で、生成AIの効果とリスクを見極められます。
料金は参考価格で500万円(税別)からです。
GPU機器の準備からモデル選定、環境構築、運用設計までをまとめて任せられるため、社内にAI専任のエンジニアがいない企業でも導入を進めやすいのが特長です。
採用する推論エンジンは、相談時にvLLMの利用可否を確認しておくと安心です。
Aurant Technologies(ローカルLLM導入支援)
https://aurant-technologies.com
Aurant Technologiesは、ローカルLLMの環境構築から社内RAGの開発までを支援している企業です。
本記事の導入事例で紹介した、金融機関の規程・法令RAGの構築も同社の支援によるものです。
vLLMとLlama 3.1 70Bを組み合わせた完全オンプレミス構成のほか、製造業での設計書検索RAGなど、業界ごとの導入事例を公開しています。
機密データはローカルLLMで、一般的な業務はクラウドのAIで処理するといった、両者を使い分けるハイブリッド構成の提案も行っています。
費用の目安も公開されており、GPUを含むサーバー費用は規模に応じて50〜500万円程度、構築支援の費用は100〜300万円程度が一般的としています。
費用感を事前に把握したうえで、中規模のRAGシステムを導入したい企業に向いています。
まとめ|vLLMはLLMを本番環境で高速・効率的に動かすための推論エンジン
vLLMは、LLMそのものではなく、LlamaやQwenなどのLLMを高速かつ少ないGPUメモリで動かすためのオープンソースの推論エンジンです。
PagedAttentionによるメモリ管理と連続バッチ処理によって、多くのユーザーからの同時アクセスでも応答速度を保ちながら、同じGPUでより多くのリクエストを処理できます。
OpenAI互換APIを備えているため、既存のアプリから接続先を切り替えるだけで自社のLLMに移行できます。
社内チャットAI、RAGシステム、大量文書のバッチ処理など、データを社外に出さずにLLMを活用したい企業にとって、有力な選択肢です。
一方で、1人で手軽に試すならOllamaやLM Studioのほうが向いています。
まずは手軽なツールでモデルの使い勝手を確かめ、多人数での本番運用が見えてきた段階でvLLMを導入するのが、失敗の少ない進め方です。
導入はLinuxとNVIDIA製GPUの組み合わせが基本ですが、WindowsはWSL2、Macはvllm-metal、GPUのないPCはCPU版で試せます。
社内に構築を担えるエンジニアがいない場合は、本記事で紹介した導入支援企業に相談し、自社に合った規模と構成から始めてみましょう。
AIでの業務自動化・内製化ガイドを公開中
単なるツール導入で終わらせず、AIを使いこなす具体的なヒントが盛り沢山!
\無料で相談可能/
すぐにお打ち合わせご希望なら、
こちらから日程調整が可能です。
(1分で完了します)